Générateur de documentation IA : ce qu'il faut automatiser et ce qu'il faut éviter
L'automatisation est puissante, mais tout ne devrait pas être généré par l'IA. Découvrez quelles parties de votre documentation produit méritent d'être automatisées et où la touche humaine reste essentielle en 2026.
 Roozbeh Firoozmand8 min de lecture
Le mois dernier, j'ai vu une équipe produit déployer une magnifique mise à jour de l'interface… et mettre le feu à son centre d'aide en toute discrétion.
Pas littéralement. Mais presque.
La documentation affichait toujours les anciens libellés des boutons. La vidéo d'onboarding renvoyait les utilisateurs vers un menu qui n'existait plus. Le support a commencé à recevoir ces tickets « je suis bloqué » qui donnent l'impression de marcher sur un LEGO dans le noir.
C'est là que la tentation surgit : « Utilisons un générateur de documentation IA pour tout régénérer. »
Bien sûr. Vous pouvez aussi passer un steak au micro-ondes. Ce sera rapide. Ce sera aussi triste.
Voici la règle que nous appliquons : automatisez les parties de la documentation qui reposent sur des faits, pas celles qui dépendent du jugement. Dès que votre automatisation commence à deviner l'intention, vous remplacez une « doc obsolète » par une « fiction convaincante ».
(Et oui, nous aborderons la conversion d'enregistrements d'écran en documentation et le fonctionnement réel d'un générateur de guides étape par étape, sans vous mettre dans l'embarras plus tard.)
Ce qu'un générateur de documentation IA devrait faire (et pourquoi la plupart échouent)
Un générateur de documentation IA est un logiciel qui transforme des sources fiables (interfaces produit, schémas, journaux de modifications et enregistrements) en brouillons de documentation mis à jour, puis les maintient à jour grâce à des contrôles et des révisions, permettant aux équipes de livrer plus rapidement sans publier d'instructions erronées.
La plupart des équipes échouent parce qu'elles automatisent la « rédaction » au lieu d'automatiser la vérification.
L'automatisation au meilleur ROI n'est pas de « générer plus de pages ».
C'est de « détecter la dérive avant les clients ».
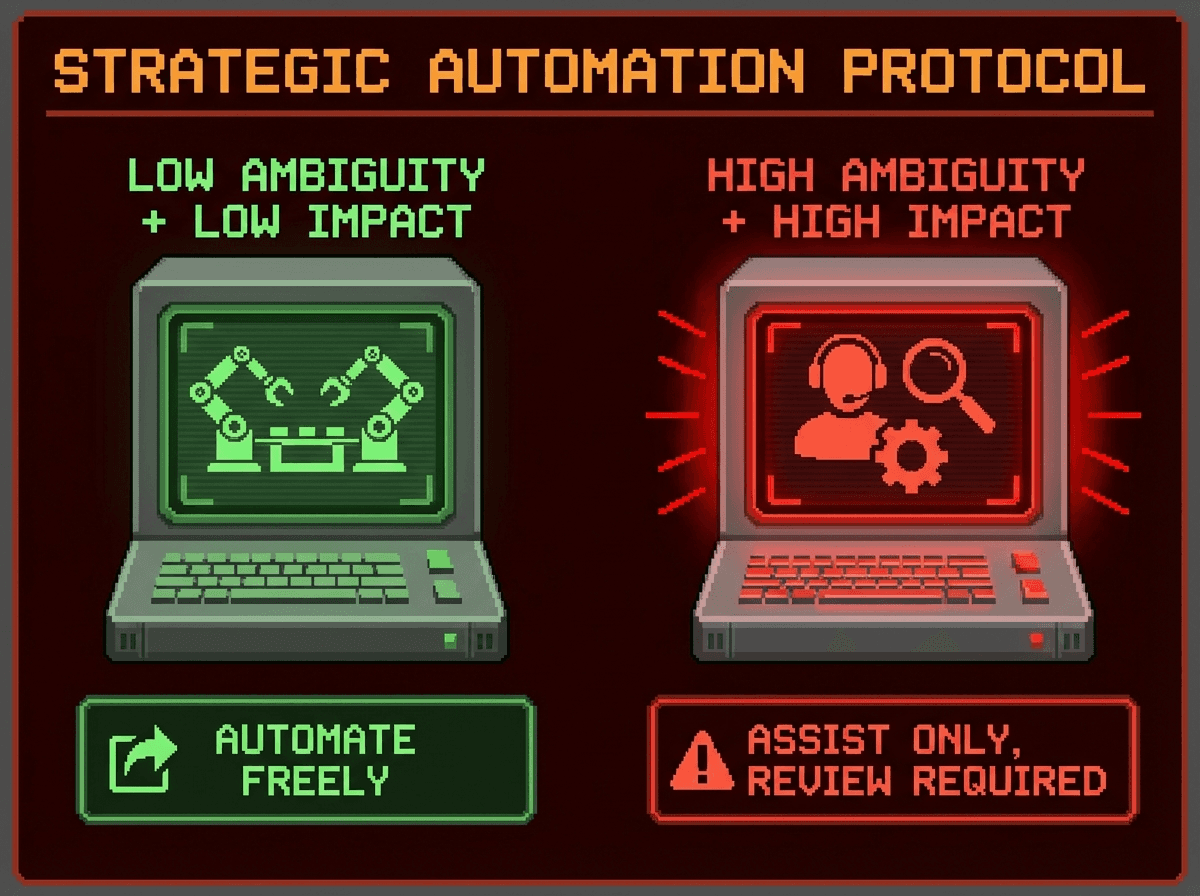
Utilisez ce cadre décisionnel : ambiguïté vs rayon d'impact
Lorsque vous décidez quoi automatiser, posez-vous deux questions :
1) Ambiguïté : cette doc nécessite-t-elle une interprétation et un contexte métier ?
2) Rayon d'impact : qui est lésé si c'est faux ?
- Faible ambiguïté + faible rayon d'impact = vous pouvez automatiser agressivement.
- Forte ambiguïté + fort rayon d'impact = automatisez uniquement comme aide à la rédaction, avec des étapes de révision strictes.
Si vous voulez une troisième question qui sauve des carrières : Ai-je une source faisant autorité que l'IA peut citer ? (Si non, elle ne devrait pas publier automatiquement.)
Cette approche se marie bien avec les flux de travail « docs as code » où la documentation est versionnée, révisée et vérifiée comme du code.
Ce qu'il faut automatiser avec un générateur de documentation IA (signal fort, faible ambiguïté)
Générer des documents de référence à partir de sources structurées
Si votre « vérité » réside dans un schéma, laissez le schéma guider.
- Schémas OpenAPI, AsyncAPI, GraphQL
- signatures typées, protobufs
- inventaires de configuration
C'est sûr car vous pouvez valider les sorties par rapport à la source et régénérer lors de la publication. Les conseils OpenAPI soutiennent fortement une réflexion structurée et orientée design pour des spécifications fiables.
Rédiger des résumés de changements, pas la « vérité finale »
Automatisez :
- les brouillons de notes de version à partir des titres de PR, labels et commits
- les diffs « ce qui a changé » pour les responsables de la doc
Gardez ensuite une étape de relecture humaine. L'IA doit mettre en lumière les changements, pas décider s'ils sont importants.
Maintenir un inventaire de docs et effectuer des contrôles de fraîcheur
Automatisez :
- quelles pages existent
- qui les possède
- quand elles ont été vérifiées pour la dernière fois par rapport à la version X
- quelles pages ont probablement dérivé après une version
C'est là que les catalogues de services brillent car ils connectent la propriété aux systèmes et maintiennent la découverte cohérente.
Appliquer la cohérence et l'hygiène
Faible risque, gain élevé :
- cohérence terminologique
- vérifications du guide de style
- liens brisés
- formatage des extraits
Les ressources de rédaction technique de Google sont une base solide pour la clarté et la cohérence lorsque vous avez besoin de quelque chose de « lisible et sobre ».
Améliorer les réponses avec la récupération, pas la génération libre
Pour les questions internes « comment faire… ? », la récupération bat l'improvisation.
Les travaux d'Anthropic sur la récupération contextuelle montrent des gains importants dans la réduction des échecs de récupération, ce qui améliore directement la fiabilité du RAG.
Ce qu'il ne faut pas automatiser (ou seulement après une révision stricte par un expert)
Si votre générateur de doc IA touche à l'un de ces points, ajoutez des verrous ou n'automatisez pas du tout :
Justification de l'architecture et compromis
L'IA peut résumer un ADR, mais elle ne peut pas déduire de manière fiable le « pourquoi nous avons choisi X » à partir du code. C'est ainsi que vous vous retrouvez avec une doc qui semble intelligente mais qui est totalement fausse.
Runbooks pouvant casser la production
Tout ce qui modifie l'état de la production (restauration de base de données, étapes d'incident, rotation de clés) nécessite un responsable, une répétition et une révision.
Conseils de sécurité et de confidentialité
Ne laissez pas un générateur automatique normaliser des modèles non sécurisés ou divulguer la topologie interne.
Revendications de performance et benchmarks
Si ce n'est pas mesuré, c'est du marketing. Gardez des humains sur ce point.
Exemples de code devant compiler ou s'exécuter
Si vous ne pouvez pas le tester en CI, ne le publiez pas automatiquement.
Mon opinion tranchée : Si vous ne pouvez pas le valider, étiquetez-le « brouillon » ou gardez-le privé. J'ai vu des docs automatiques « utiles » créer plus de travail qu'elles n'en économisent.
Enregistrement d'écran vers documentation : le raccourci qui vous garde honnête
Voici l'astuce sous-utilisée : lorsque l'ambiguïté est élevée, arrêtez de demander à l'IA d'« inventer de la clarté » et donnez-lui plutôt des preuves.
Un bon flux de travail de conversion d'enregistrement d'écran en documentation inverse le modèle :
- La source de vérité n'est pas la prose de l'IA.
- La source de vérité est le flux de travail enregistré : les clics, les champs, l'état de l'interface et la séquence.
C'est exactement pourquoi nous avons construit Clevera pour transformer des enregistrements d'écran bruts et silencieux en une vidéo produit narrée et un article structuré et riche en captures d'écran en un seul flux. L'enregistrement fournit l'ancrage, et la doc devient une relecture fidèle, pas un exercice d'écriture créative.
CTA contextuel : Si votre équipe continue de réécrire le même « comment faire » à chaque version, essayez de transformer le prochain flux de travail en un enregistrement Clevera et exportez-le directement vers votre centre d'aide ou wiki. Vous sentirez la différence la première fois que vous n'aurez pas à courir après les captures d'écran.
Insight non-Googlable que nous utilisons en interne : Traitez chaque doc de type « comment faire » comme « une relecture », pas « une page ».
Si vous ne pouvez pas rejouer comment le résultat a été produit, vous êtes à un changement d'interface près du non-sens.
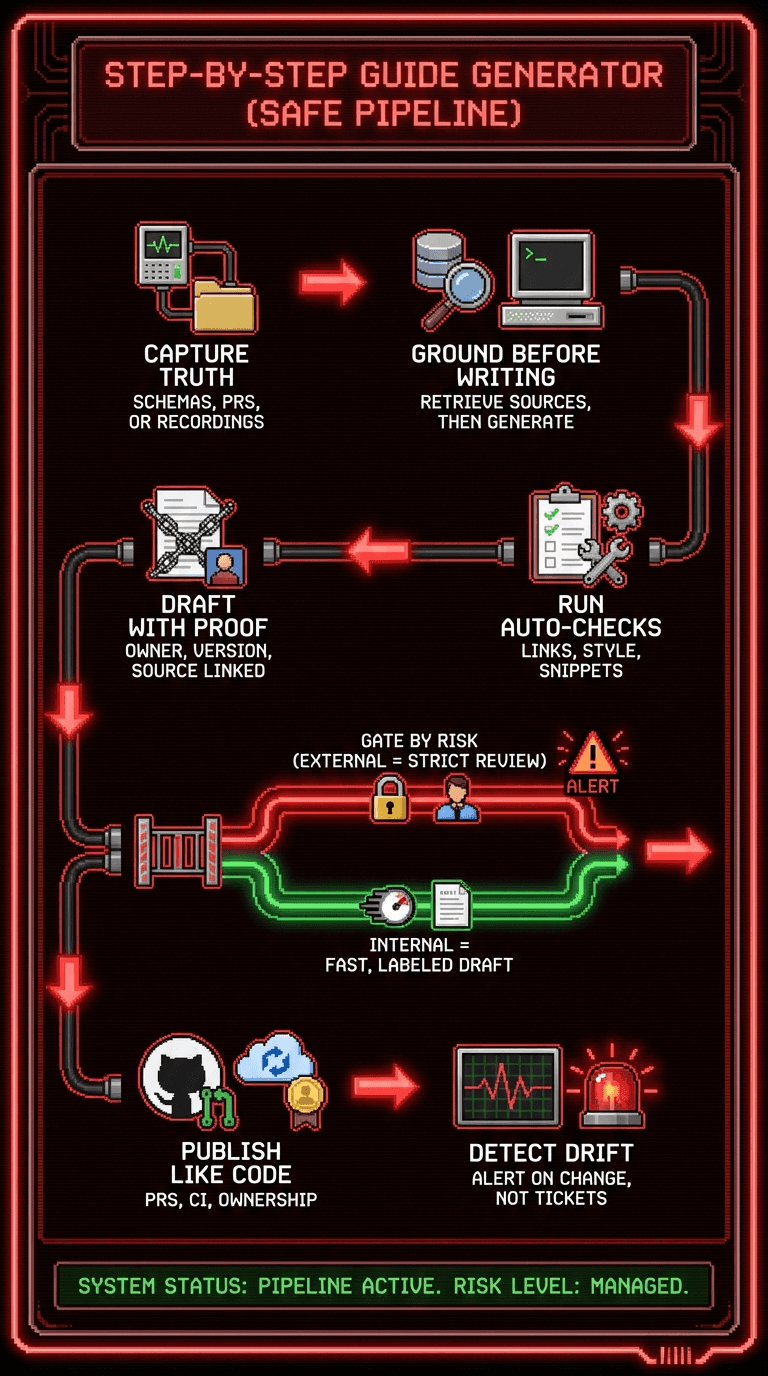
Un pipeline de générateur de guides étape par étape qui ne vous mettra pas dans l'embarras
Un générateur de guides étape par étape ne devient digne de confiance que lorsque vous l'exécutez comme un pipeline d'ingénierie, pas comme une machine à sous de contenu.
Voici le flux de travail que je recommande :
- Capturer des entrées faisant autorité
- schémas, métadonnées de PR ou enregistrements (idéal pour les flux UI)
- Ancrer d'abord, générer ensuite
- récupération avec citations, ou extraction déterministe à partir de sources structurées
- Générer un brouillon avec des « métadonnées de vérification »
- propriétaire, dernière version vérifiée, PR source liée, « brouillon vs vérifié »
- Exécuter des contrôles automatisés
- vérification des liens, du style, formatage des extraits
- Filtrer par risque
- docs externes : révision et versionnage plus stricts
- docs internes : plus rapide, mais étiquetez clairement les brouillons
- Publier comme du code
- révision de PR, passages CI, propriété claire
- Détecter la dérive
- alertes « ce qui a changé » au propriétaire
- n'attendez pas que les tickets de support soient votre système de surveillance
Cela s'aligne également avec l'objectif principal de l'ingénierie de plateforme : réduire la charge cognitive avec des « chemins dorés » clairs au lieu de laisser tout le monde explorer les connaissances tribales.
Premières victoires que vous pouvez livrer en deux semaines
Si vous partez du chaos, ne faites pas une « grande réécriture ». Faites trois petites automatisations qui se cumulent :
- Génération de docs de référence
- schéma vers docs, régénérer par version
- Détection d'obsolescence
- propriétaires + métadonnées « dernière vérification par rapport à »
- Brouillons de notes de version
- auto-brouillon, étape de relecture humaine
Ce sont les automatisations les plus sûres avec le gain le plus rapide en « déflexion de tickets de support ».
Des visuels qui prouvent que vos docs sont réelles (pas du papier peint d'entreprise)
Évitez les photos de stock de poignées de main. Utilisez des preuves :
- Une capture d'écran du tableau de bord des écarts montrant les pages « vérifiées pour cette version » par rapport aux « inconnues »
- Texte alternatif : « Tableau de bord du générateur de documentation par IA montrant les pages du centre d'aide vérifiées par rapport aux obsolètes »
- Une séquence de captures d'écran annotées (chiffres + flèches) pour une étape de workflow
- Texte alternatif : « Enregistrement d'écran vers une sortie de documentation avec des étapes numérotées et des éléments d'interface mis en évidence »
- Un comparatif avant/après d'un document mis à jour à partir d'une PR de version
Si vous publiez des tutoriels, intégrez la vidéo au-dessus de l'article afin que les utilisateurs puissent choisir leur style d'apprentissage préféré. Clevera exporte exactement ce format : vidéo en haut, article étape par étape en dessous.
Votre prochaine étape
Choisissez un document sur lequel vos clients comptent cette semaine.
Dessinez rapidement une matrice 2×2 : ambiguïté vs rayon d'impact.
Automatisez ensuite une partie sans risque (référence, détection des écarts ou guides basés sur des enregistrements) et ajoutez une étape de validation pour la partie risquée.
Si vous le faites correctement, vous ne publierez pas seulement plus vite. Vous dormirez mieux.
Défi : Quel est le document « qui semble fiable mais qui est faux » dans votre produit en ce moment, et quelle source permettrait de le rendre rejouable : un schéma, un diff de PR ou un enregistrement d'écran ?