AIドキュメント生成ツール:自動化すべきこと、すべきでないこと
自動化は強力ですが、すべてをAIに任せるべきではありません。2026年現在、製品ドキュメントのどの部分を自動化し、どこに人間の手が必要なのかを解説します。
 Roozbeh Firoozmand3分で読めます
先月、ある製品チームが素晴らしいUIアップデートをリリースしたのを見ましたが……彼らは静かにヘルプセンターを炎上させていました。
文字通りではありませんが、それに近い状態です。
ドキュメントには古いボタンラベルが残ったままで、オンボーディング動画は存在しないメニューを指し示していました。サポートには、暗闇でレゴブロックを踏んだときのような「詰まりました」というチケットが届き始めました。
そこで誘惑に駆られるわけです。「AIドキュメント生成ツールを使って、すべて作り直そう」と。
確かに。ステーキを電子レンジで調理することもできます。速いでしょう。しかし、悲惨な結果になるはずです。
私たちが採用しているルールはこれです。事実として扱える部分は自動化し、判断を要する部分は自動化しないこと。自動化が推測を始めた瞬間、あなたは「古いドキュメント」を「自信満々なフィクション」と交換することになります。
(もちろん、画面録画からドキュメントを作成する方法や、ステップバイステップガイド生成ツールが、後で恥をかかないためにどう機能すべきかについても解説します。)
AIドキュメント生成ツールがすべきこと(そして、なぜ多くが失敗するのか)
AIドキュメント生成ツールとは、信頼できるソース(製品UI、スキーマ、変更履歴、録画など)を最新のドキュメントドラフトに変換し、チェックとレビューを通じて常に最新の状態に保つソフトウェアです。これにより、チームは誤った手順を公開することなく、より速くリリースできるようになります。
多くのチームが失敗するのは、「執筆」を自動化してしまい、「検証」を自動化していないからです。
最もROIが高い自動化とは「ページを増やすこと」ではありません。 「顧客が気づく前に情報の乖離を検知すること」です。
この意思決定フレームワークを活用しよう:曖昧さと影響範囲
何を自動化するかを決める際、次の2つの質問をしてください。
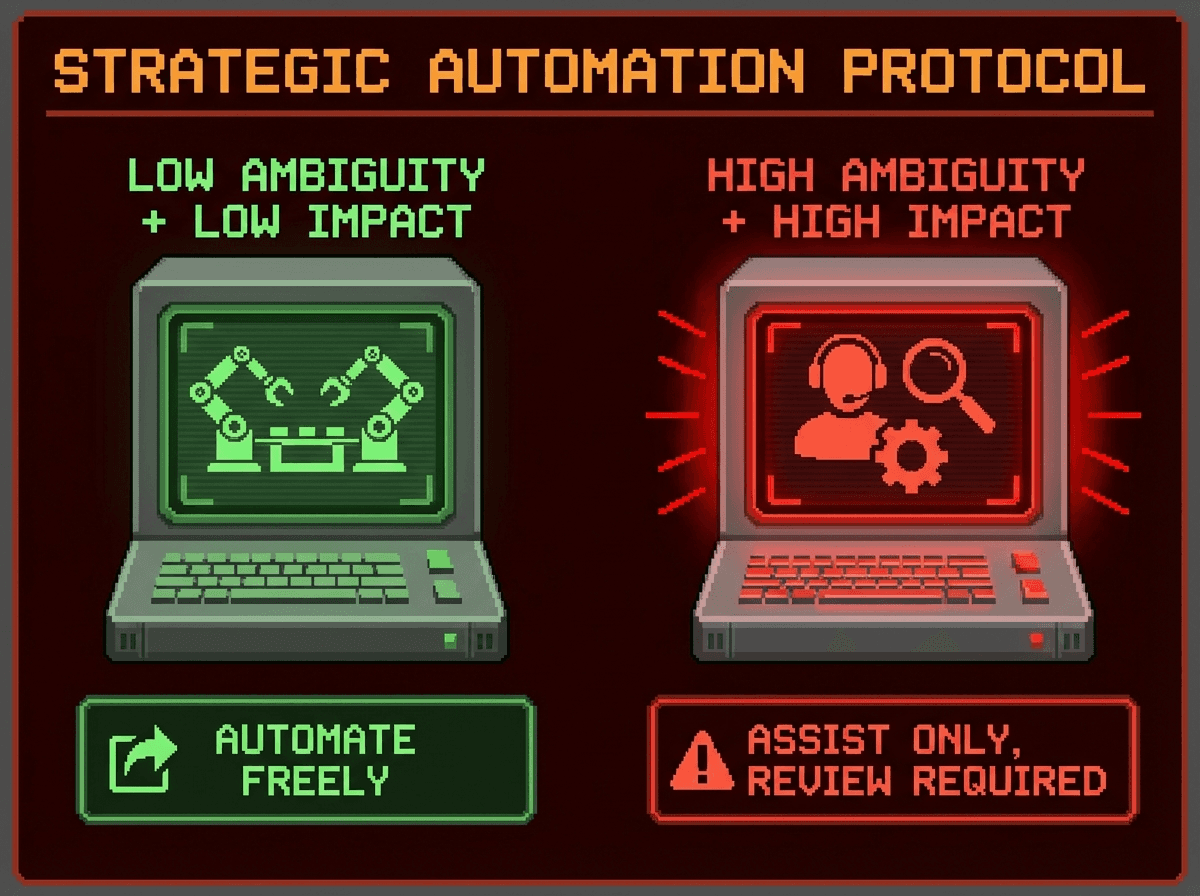
1) 曖昧さ: このドキュメントは解釈や組織特有の背景知識を必要とするか? 2) 影響範囲: これが間違っていた場合、誰が困るか?
- 曖昧さが低く、影響範囲も小さい = 積極的に自動化してよい。
- 曖昧さが高く、影響範囲も大きい = 厳格なレビューゲートを設けた上で、ドラフト作成支援としてのみ自動化する。
キャリアを守るための3つ目の質問:AIが引用できる信頼できるソースはあるか? (もしなければ、自動公開すべきではありません。)
この考え方は、ドキュメントをソフトウェアのようにバージョン管理し、レビューやチェックを行う「docs as code」ワークフローと相性が抜群です。
AIドキュメント生成ツールで自動化すべきこと(シグナルが高く、曖昧さが低いもの)
構造化されたソースからリファレンスドキュメントを生成する
「真実」がスキーマにあるなら、スキーマを主導させましょう。
- OpenAPI、AsyncAPI、GraphQLスキーマ
- 型定義、protobuf
- 設定インベントリ
これはソースに対して出力を検証し、リリース時に再生成できるため安全です。OpenAPIのガイダンスは、信頼性の高い仕様のために構造化された設計ファーストの考え方を強く推奨しています。
「最終的な真実」ではなく、変更の要約をドラフトする
自動化すべきこと:
- PRタイトル、ラベル、コミットからのリリースノートのドラフト作成
- ドキュメント担当者向けの「何が変わったか」の差分表示
その上で、人間による編集プロセスを挟んでください。AIは変更箇所を強調すべきであり、それが重要かどうかを判断すべきではありません。
ドキュメントのインベントリを管理し、鮮度チェックを実行する
自動化すべきこと:
- どのページが存在するか
- 誰が所有者か
- バージョンXに対して最後にいつ検証されたか
- リリース後に乖離した可能性が高いページはどれか
ここでサービスカタログが役立ちます。所有権をシステムと結びつけ、情報の発見を健全に保てるからです。
一貫性と衛生状態を強制する
低リスクで効果が高いもの:
- 用語の一貫性
- スタイルガイドのチェック
- リンク切れの修正
- スニペットのフォーマット
Googleのテクニカルライティングリソースは、「退屈だが読みやすい」ドキュメントが必要な際の、明確さと一貫性のための確かな基準となります。
フリーフォーム生成ではなく、検索(Retrieval)で回答を改善する
社内の「〜するには?」という質問に対しては、雰囲気で答えるよりも検索が勝ります。
AnthropicによるContextual Retrievalの研究は、検索失敗を減らす上で大きな成果を示しており、RAGの信頼性を直接的に向上させています。
自動化すべきでないこと(または、SMEの厳格なレビューが必要なもの)
AIドキュメント生成ツールがこれらに触れる場合は、ゲートを追加するか、自動化を避けてください。
アーキテクチャの根拠とトレードオフ
AIはADR(アーキテクチャ決定記録)を要約できますが、コードから「なぜXを選んだのか」を確実に推論することはできません。そうすると、賢そうに見えて完全に間違ったドキュメントが出来上がります。
本番環境を壊す可能性のある手順書
本番環境の状態を変更するもの(DBの復元、インシデント対応手順、鍵のローテーションなど)には、所有者、リハーサル、レビューが不可欠です。
セキュリティとプライバシーのガイダンス
自動生成ツールに、安全でないパターンを標準化させたり、内部トポロジーを漏洩させたりしてはいけません。
パフォーマンスの主張とベンチマーク
測定されていないものは、ただのマーケティングです。これは人間が担当してください。
コンパイルや実行が必要なコードサンプル
CIでテストできないものは、自動公開しないでください。
私の独断的なルール:検証できないなら「ドラフト」とラベル付けするか、非公開にすること。 「親切な」自動ドキュメントが、かえって手間を増やす現場を何度も見てきました。
画面録画からドキュメントへ:誠実さを保つための近道
あまり知られていないコツがあります。曖昧さが高いときは、AIに「明快さを発明」させるのではなく、証拠を与えてください。
優れた画面録画からドキュメントを作成するワークフローは、モデルを反転させます。
- 真実のソースはAIの文章ではない。
- 真実のソースは録画されたワークフロー(クリック、フィールド、UIの状態、手順)である。
これこそが、私たちがCleveraを構築した理由です。生の無音の画面録画を、ナレーション付きの製品動画と、スクリーンショットが豊富な構造化された記事に一度のフローで変換します。録画が根拠となり、ドキュメントは創造的なライティングの練習ではなく、忠実なリプレイとなります。
コンテキストに応じたCTA: もしあなたのチームがリリースごとに同じ「使い方」を書き直しているなら、次のワークフローをCleveraで録画し、ヘルプセンターや(Proプラン以上なら)Wikiに直接エクスポートしてみてください。スクリーンショットを追いかける必要がなくなった瞬間に、その違いを実感できるはずです。
社内で共有している、Google検索では見つからない洞察:すべてのハウツー記事を「ページ」ではなく「リプレイ」として扱うこと。 結果がどのように生成されたかをリプレイできなければ、UIが一度変わるだけで、それは意味をなさないものになってしまいます。
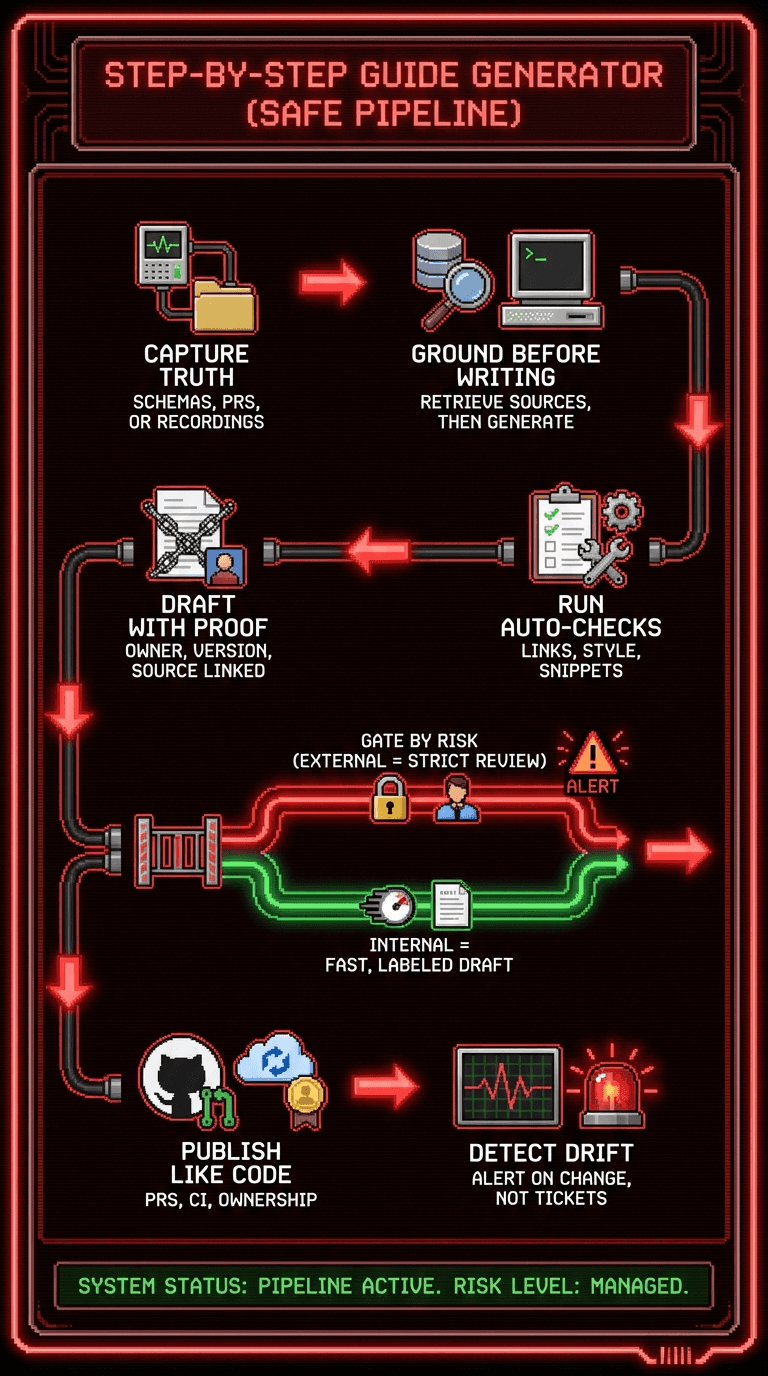
恥をかかないためのステップバイステップガイド生成パイプライン
ステップバイステップガイド生成ツールは、コンテンツのガチャマシンではなく、エンジニアリングのパイプラインとして運用して初めて信頼できるものになります。
推奨するワークフローは以下の通りです。
- 信頼できる入力をキャプチャする
- スキーマ、PRメタデータ、または録画(UIワークフローに最適)
- まず根拠を固め、次に生成する
- 引用付きの検索、または構造化ソースからの決定論的な抽出
- 「検証メタデータ」付きのドラフトを生成する
- 所有者、最終検証バージョン、リンクされたソースPR、「ドラフトか検証済みか」
- 自動チェックを実行する
- リンクチェック、スタイルチェック、スニペットのフォーマット
- リスクに応じてゲートを設ける
- 外部ドキュメント:より厳格なレビューとバージョン管理
- 内部ドキュメント:より迅速に、ただしドラフトであることを明記
- コードのように公開する
- PRレビュー、CIパス、明確な所有権
- 乖離を検知する
- 所有者への「何が変わったか」のアラート
- サポートチケットが監視システムになるのを待たない
これはプラットフォームエンジニアリングの核心的な目標とも一致します。誰もが部族知識(暗黙知)の中を探索するのではなく、明確な「ゴールデンパス」で認知負荷を軽減するのです。
2週間で実現できる最初の成果
混沌とした状態から始めるなら、「大規模な書き直し」はしないでください。相乗効果を生む3つの小さな自動化を行いましょう。
- リファレンスドキュメントの生成
- スキーマからドキュメントへ、リリースごとに再生成
- 陳腐化の検知
- 所有者 + 「最終検証バージョン」メタデータ
- 変更履歴のドラフト
- 自動ドラフト作成、人間による編集プロセス
これらは最も安全で、「サポートチケットの削減」という成果を最も早く得られる自動化です。
ドキュメントが本物であることを証明するビジュアル(企業の壁紙ではない)
握手するストックフォトはスキップしましょう。証拠を使ってください。
- ドリフトダッシュボードのスクリーンショット:「今回のリリースで検証済み」のページと「不明」なページを表示
- Alt text: 「検証済みと古いヘルプセンターページを表示するAIドキュメント生成ダッシュボード」
- 注釈付きのスクリーンショットシーケンス(番号と矢印):ワークフローのステップを表示
- Alt text: 「番号付きステップとハイライトされたUI要素を備えた、画面録画からドキュメントへの出力」
- Before/Afterの差分:リリースPRから更新されたドキュメント
チュートリアルを公開する場合は、記事の上に動画を埋め込むことで、ユーザーが好みの学習スタイルを選択できるようにしましょう。Cleveraはまさにこの形式、つまり上部に動画、その下にステップバイステップの記事という形式でエクスポートします。
次のアクション
今週、顧客が頼りにしているドキュメントを1つ選んでください。
「曖昧さ」と「影響範囲」の2×2マトリクスを簡単に描いてみましょう。
次に、安全な部分(リファレンス、ドリフト検知、録画ベースのハウツー記事)を1つ自動化し、リスクの高い部分にはレビューゲートを設けてください。
正しく行えば、公開スピードが上がるだけでなく、安心して眠れるようになるはずです。
課題: 現在のプロダクトの中で「もっともらしく見えるが間違っている」ドキュメントはどれですか?また、それを再現可能にするために必要な入力情報(スキーマ、PRの差分、画面録画のいずれか)は何でしょうか?