Generator dokumentasi AI: apa yang harus diotomatisasi dan apa yang tidak
Otomatisasi memang hebat, tetapi tidak semuanya harus dibuat oleh AI. Cari tahu bagian mana dari dokumentasi produk Anda yang harus diotomatisasi dan di mana sentuhan manusia masih sangat penting di tahun 2026.
 Roozbeh Firoozmand7 menit baca
Bulan lalu, saya melihat tim produk merilis pembaruan UI yang indah… dan secara diam-diam membakar pusat bantuan mereka.
Bukan secara harfiah. Tapi hampir.
Dokumen tersebut masih menampilkan label tombol yang lama. Video onboarding masih mengarahkan pengguna ke menu yang sudah tidak ada lagi. Tim dukungan mulai menerima tiket “Saya bingung” yang rasanya seperti menginjak LEGO dalam kegelapan.
Saat itulah godaan muncul: “Mari kita gunakan generator dokumentasi AI untuk membuat ulang semuanya.”
Tentu. Dan Anda juga bisa memanaskan steak di microwave. Memang cepat. Tapi juga menyedihkan.
Inilah aturan yang kami gunakan: otomatisasi bagian dokumentasi yang bersifat fakta, bukan bagian yang bergantung pada penilaian. Saat otomatisasi Anda mulai menebak maksud, Anda telah menukar “dokumen basi” dengan “fiksi yang meyakinkan.”
(Dan ya, kami akan membahas perekaman layar untuk dokumentasi dan bagaimana generator panduan langkah demi langkah seharusnya bekerja, tanpa membuat Anda malu nantinya.)
Apa yang harus dilakukan generator dokumentasi AI (dan mengapa kebanyakan gagal)
Generator dokumentasi AI adalah perangkat lunak yang mengubah sumber tepercaya (seperti UI produk, skema, log perubahan, dan rekaman) menjadi draf dokumentasi yang diperbarui, lalu menjaganya tetap terkini melalui pemeriksaan dan tinjauan, sehingga tim dapat merilis lebih cepat tanpa menerbitkan instruksi yang salah.
Kebanyakan tim gagal karena mereka mengotomatisasi “penulisan” alih-alih mengotomatisasi verifikasi.
Otomatisasi dengan ROI tertinggi bukanlah “menghasilkan lebih banyak halaman.” Ini adalah “menangkap penyimpangan sebelum pelanggan menemukannya.”
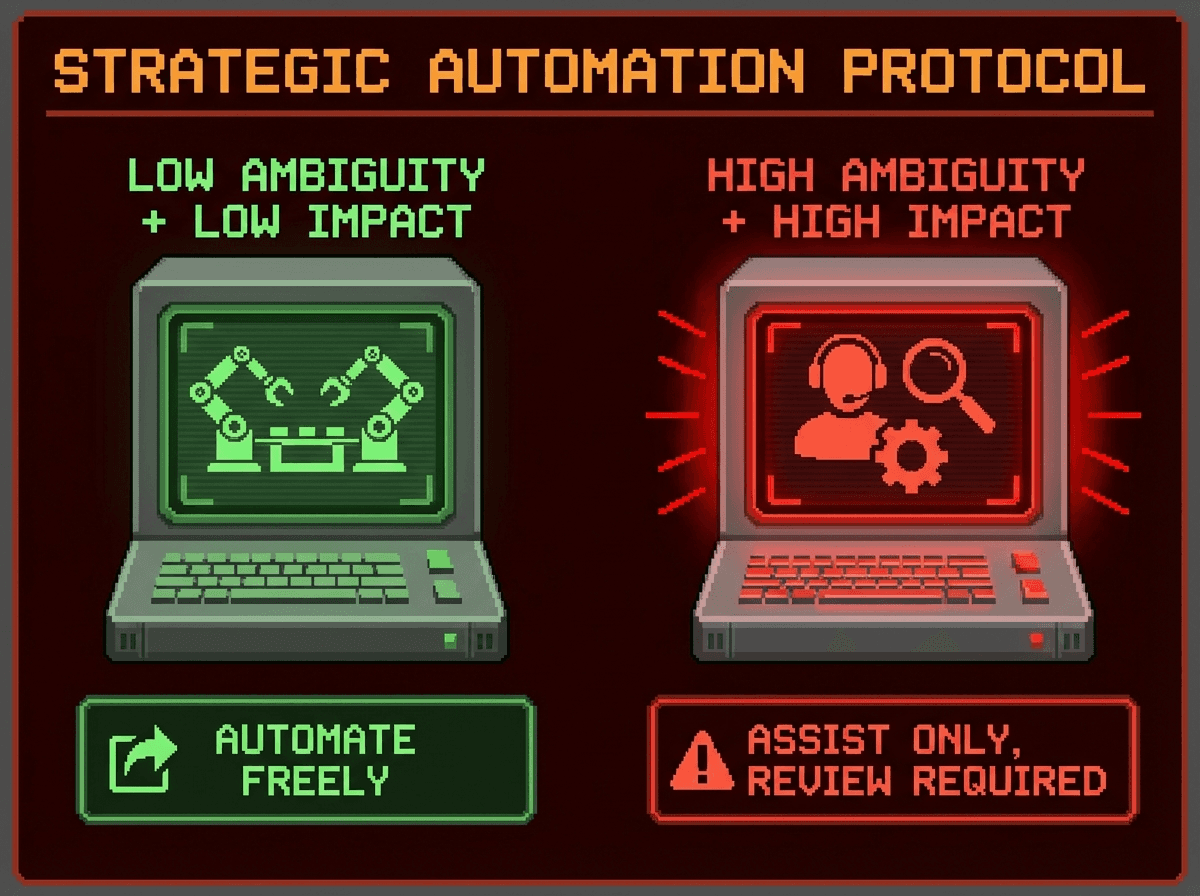
Gunakan kerangka kerja keputusan ini: ambiguitas vs radius dampak
Saat Anda memutuskan apa yang akan diotomatisasi, ajukan dua pertanyaan:
1) Ambiguitas: apakah dokumen ini memerlukan interpretasi dan konteks internal? 2) Radius dampak: siapa yang dirugikan jika ini salah?
- Ambiguitas rendah + radius dampak rendah = Anda dapat melakukan otomatisasi secara agresif.
- Ambiguitas tinggi + radius dampak tinggi = otomatisasi hanya sebagai draf bantuan, dengan gerbang tinjauan yang ketat.
Jika Anda menginginkan pertanyaan ketiga yang menyelamatkan karier: Apakah saya memiliki sumber otoritatif yang dapat dikutip oleh AI? (Jika tidak, jangan otomatis menerbitkannya.)
Pola pikir ini sangat cocok dengan alur kerja “docs as code” di mana dokumen diberi versi, ditinjau, dan diperiksa seperti perangkat lunak.
Apa yang harus diotomatisasi dengan generator dokumentasi AI (sinyal tinggi, ambiguitas rendah)
Hasilkan dokumen referensi dari sumber terstruktur
Jika “kebenaran” Anda ada dalam skema, biarkan skema yang memimpin.
- Skema OpenAPI, AsyncAPI, GraphQL
- tanda tangan bertipe, protobuf
- inventaris konfigurasi
Ini aman karena Anda dapat memvalidasi output terhadap sumber dan membuatnya ulang saat rilis. Panduan OpenAPI sangat mendukung pemikiran terstruktur yang mengutamakan desain untuk spesifikasi yang andal.
Buat draf ringkasan perubahan, bukan “kebenaran akhir”
Otomatisasi:
- draf catatan rilis dari judul PR, label, dan commit
- diff “apa yang berubah” untuk pemilik dokumen
Kemudian lakukan tinjauan manusia. AI harus menyoroti perubahan, bukan memutuskan apakah perubahan itu penting.
Simpan inventaris dokumen dan jalankan pemeriksaan kesegaran
Otomatisasi:
- halaman mana yang ada
- siapa pemiliknya
- kapan terakhir kali diverifikasi terhadap versi X
- halaman mana yang kemungkinan menyimpang setelah rilis
Di sinilah katalog layanan bersinar karena mereka menghubungkan kepemilikan ke sistem dan menjaga penemuan tetap masuk akal.
Tegakkan konsistensi dan kebersihan
Risiko rendah, hasil tinggi:
- konsistensi terminologi
- pemeriksaan panduan gaya
- tautan rusak
- pemformatan cuplikan
Sumber daya penulisan teknis Google adalah dasar yang kuat untuk kejelasan dan konsistensi saat Anda membutuhkan sesuatu yang “membosankan dan mudah dibaca.”
Tingkatkan jawaban dengan pengambilan, bukan pembuatan bebas
Untuk pertanyaan internal “bagaimana cara…?”, pengambilan data lebih baik daripada sekadar tebakan.
Pekerjaan Anthropic pada Contextual Retrieval menunjukkan peningkatan besar dalam mengurangi kegagalan pengambilan, yang secara langsung meningkatkan keandalan RAG.
Apa yang tidak boleh diotomatisasi (atau hanya di belakang tinjauan SME yang ketat)
Jika generator dokumen AI Anda menyentuh salah satu dari ini, tambahkan gerbang atau jangan diotomatisasi sama sekali:
Dasar pemikiran arsitektur dan trade-off
AI dapat meringkas ADR, tetapi tidak dapat menyimpulkan “mengapa kita memilih X” dari kode dengan andal. Begitulah cara Anda mendapatkan dokumen yang terdengar cerdas tetapi sepenuhnya salah.
Runbook yang dapat merusak produksi
Apa pun yang mengubah status produksi (pemulihan DB, langkah insiden, rotasi kunci) memerlukan pemilik, latihan, dan tinjauan.
Panduan keamanan dan privasi
Jangan biarkan generator otomatis menormalkan pola yang tidak aman atau membocorkan topologi internal.
Klaim kinerja dan tolok ukur
Jika tidak diukur, itu adalah pemasaran. Biarkan manusia yang menanganinya.
Contoh kode yang harus dikompilasi atau dijalankan
Jika Anda tidak dapat mengujinya di CI, jangan terbitkan secara otomatis.
Pendapat saya: Jika Anda tidak dapat memvalidasinya, beri label “draf” atau simpan secara pribadi. Saya telah melihat dokumen otomatis yang “membantu” justru menciptakan lebih banyak pekerjaan daripada yang dihemat.
Perekaman layar ke dokumentasi: jalan pintas yang menjaga Anda tetap jujur
Inilah trik yang kurang dimanfaatkan: saat ambiguitas tinggi, berhentilah meminta AI untuk “menciptakan kejelasan” dan berikan bukti sebagai gantinya.
Alur kerja perekaman layar ke dokumentasi yang baik mengubah modelnya:
- Sumber kebenaran bukanlah prosa AI.
- Sumber kebenaran adalah alur kerja yang direkam: klik, bidang, status UI, dan urutan.
Inilah alasan tepat kami membangun Clevera untuk mengubah rekaman layar mentah tanpa suara menjadi video produk yang dinarasikan dan artikel terstruktur yang kaya tangkapan layar dalam satu alur. Rekaman memberikan dasar, dan dokumen menjadi tayangan ulang yang setia, bukan latihan menulis kreatif.
CTA Kontekstual: Jika tim Anda terus menulis ulang “cara melakukan” yang sama setiap rilis, cobalah mengubah alur kerja berikutnya menjadi rekaman Clevera dan ekspor langsung ke pusat bantuan Anda atau, pada paket Pro ke atas, wiki Anda. Anda akan merasakan perbedaannya saat pertama kali Anda tidak perlu lagi mengejar tangkapan layar.
Wawasan yang tidak bisa dicari di Google yang kami gunakan secara internal: Perlakukan setiap dokumen cara-melakukan sebagai “tayangan ulang,” bukan “halaman.” Jika Anda tidak dapat memutar ulang bagaimana hasilnya diproduksi, Anda hanya berjarak satu perubahan UI dari omong kosong.
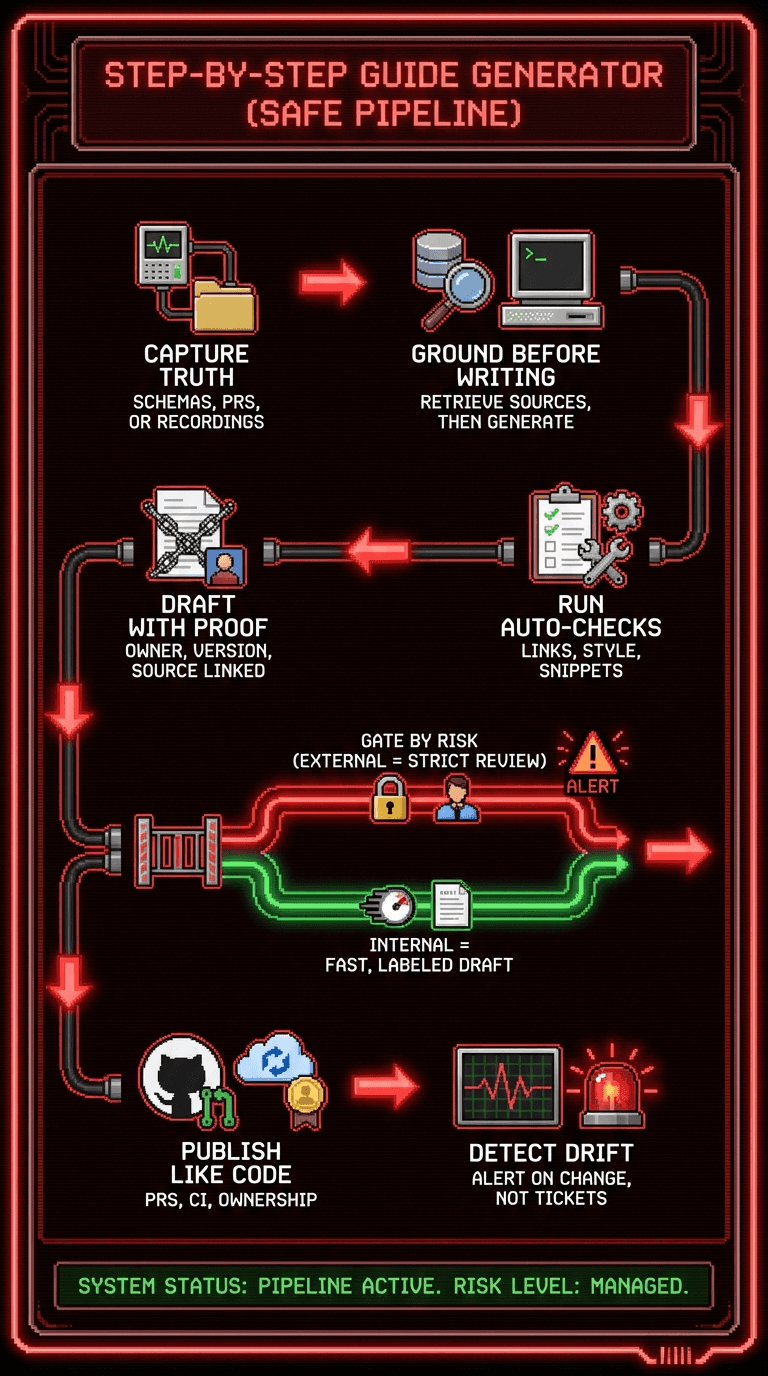
Pipa generator panduan langkah demi langkah yang tidak akan membuat Anda malu
Generator panduan langkah demi langkah hanya menjadi tepercaya saat Anda menjalankannya seperti pipa rekayasa, bukan mesin slot konten.
Berikut adalah alur kerja yang saya sarankan:
- Tangkap input otoritatif
- skema, metadata PR, atau rekaman (terbaik untuk alur kerja UI)
- Dasari dulu, hasilkan kemudian
- pengambilan dengan kutipan, atau ekstraksi deterministik dari sumber terstruktur
- Hasilkan draf dengan “metadata verifikasi”
- pemilik, versi terakhir diverifikasi, PR sumber tertaut, “draf vs diverifikasi”
- Jalankan pemeriksaan otomatis
- pemeriksaan tautan, pemeriksaan gaya, pemformatan cuplikan
- Gerbang berdasarkan risiko
- dokumen eksternal: tinjauan dan pembuatan versi yang lebih ketat
- dokumen internal: lebih cepat, tetapi beri label draf dengan jelas
- Terbitkan seperti kode
- tinjauan PR, lolos CI, kepemilikan yang jelas
- Deteksi penyimpangan
- peringatan “apa yang berubah” kepada pemilik
- jangan menunggu tiket dukungan menjadi sistem pemantauan Anda
Ini juga sejalan dengan tujuan utama rekayasa platform: mengurangi beban kognitif dengan “jalan emas” yang jelas alih-alih membiarkan semua orang mencari-cari melalui pengetahuan suku.
Kemenangan pertama yang bisa Anda rilis dalam dua minggu
Jika Anda memulai dari kekacauan, jangan lakukan “penulisan ulang besar-besaran.” Lakukan tiga otomatisasi kecil yang saling melengkapi:
- Pembuatan dokumen referensi
- skema ke dokumen, buat ulang per rilis
- Deteksi keusangan
- pemilik + metadata “terakhir diverifikasi terhadap”
- Draf log perubahan
- draf otomatis, tinjauan manusia
Ini adalah otomatisasi teraman dengan hasil “pengalihan tiket dukungan” tercepat.
Visual yang membuktikan dokumen Anda nyata (bukan wallpaper perusahaan)
Lewati foto stok jabat tangan. Gunakan bukti:
- Tangkapan layar dasbor drift yang menampilkan halaman “diverifikasi rilis ini” vs “tidak diketahui”
- Teks alternatif: “Dasbor generator dokumentasi AI yang menampilkan halaman pusat bantuan yang terverifikasi vs usang”
- Urutan tangkapan layar beranotasi (angka + panah) untuk langkah alur kerja
- Teks alternatif: “Rekaman layar ke output dokumentasi dengan langkah bernomor dan elemen UI yang disorot”
- Perbandingan sebelum/sesudah dari dokumen yang diperbarui dari PR rilis
Jika Anda menerbitkan tutorial, sematkan video di atas artikel agar pengguna dapat memilih gaya belajar yang mereka sukai. Clevera mengekspor format yang tepat ini: video di bagian atas, artikel langkah demi langkah di bawahnya.
Langkah Anda selanjutnya
Pilih satu dokumen yang diandalkan pelanggan Anda minggu ini.
Buat matriks 2×2 cepat: ambiguitas vs radius dampak.
Kemudian otomatisasi satu bagian yang aman (referensi, deteksi drift, atau dokumen panduan berbasis rekaman) dan pasang gerbang peninjauan pada bagian yang berisiko.
Jika Anda melakukannya dengan benar, Anda tidak hanya akan menerbitkan lebih cepat. Anda akan tidur lebih nyenyak.
Tantangan: Apa satu dokumen “terlihat otoritatif tetapi salah” di produk Anda saat ini, dan input mana yang akan membuatnya dapat diputar ulang: skema, diff PR, atau rekaman layar?