Yapay zeka ile bilgi tabanı nasıl oluşturulur
Destek biletlerini denetlemekten, cilalı yardım makalelerini otomatik olarak yayınlamaya kadar yapay zeka ile nasıl bilgi tabanı oluşturacağınızı öğrenin. Destek ekipleri için pratik bir rehber.
 Roozbeh Firoozmand5 dk okuma
Destek ekibiniz her hafta aynı 20 soruyu yanıtlıyor. Müşteriler bekliyor. Biletler birikiyor. Bir bilgi tabanı bunu çözer, ancak sıfırdan bir tane oluşturmak her zaman darboğaz olmuştur. Doğru yapay zeka araçlarıyla bu durum değişiyor.
Bu rehber, ne yazılacağını bulmaktan, kadroda özel bir yazar olmadan makaleleri güncel tutmaya kadar yapay zeka ile adım adım nasıl bilgi tabanı oluşturacağınızı kapsar.
Bilgi tabanı projeleri neden duraksar
Çoğu ekipte bilgi eksikliği yoktur. Bilgiyi belgeleme zamanları yoktur. Kıdemli bir destek mühendisi, en önemli 10 sorununuzu nasıl ele alacağını tam olarak bilir, ancak her biri için net ve aranabilir yardım makaleleri üretmek, sahip olmadıkları saatler sürer.
Yapay zeka destekli bilgi tabanı oluşturma, işin nerede yapıldığını değiştirir. Makaleleri sıfırdan yazmak yerine, ekibinizde zaten var olan uzmanlıktan makaleler üretmesi için yapay zekayı yönlendirirsiniz. Darboğaz "yazmak için zaman bul"dan, "sorunu çözerken kendini kaydet"e geçer; bu çok daha hızlı bir döngüdür.
1. Adım: Bir şey yazmadan önce destek biletlerinizi denetleyin
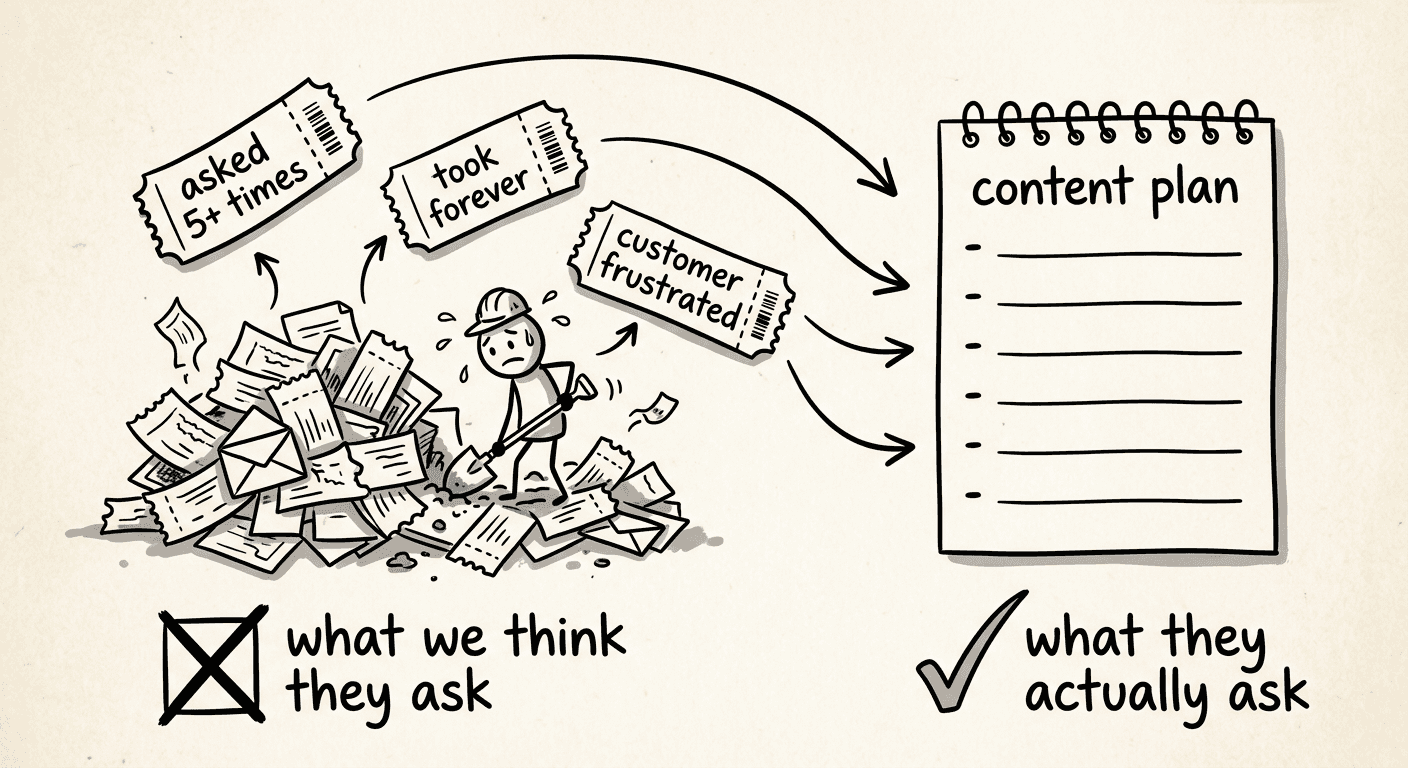
Ekiplerin yaptığı en büyük hata, hangi makalelerin yazılacağını tahmin etmektir. Tek bir içerik oluşturmadan önce, son 90 gündeki en yaygın destek sorgularınızı çekin.
Şunları arıyorsunuz:
- 5 kereden fazla görünen sorular
- Bir bilette çözülmesi 5 dakikadan fazla süren sorunlar
- Müşterilerin kendi başlarına bilgi bulma konusunda hayal kırıklığı ifade ettikleri konular
Bu liste sizin içerik planınızdır. Çoğu yardım masası (Zendesk, Intercom, Freshdesk) biletleri etiket veya kategoriye göre filtrelemenize ve dışa aktarmanıza olanak tanır. Bunu düzgün yapmak için zaman ayırın. Yanlış soruları yanıtlayan bir bilgi tabanı hiçbir şeyi önlemez.
Konuları, iç ekiplerinizin nasıl organize edildiğine göre değil, müşterilerinizin nasıl düşündüğüne uyan 6-10 kategoriye ayırın. Müşteriler buna "faturalandırma" diyorsa, kategoriniz "gelir operasyonları" değil, "faturalandırma"dır.
2. Adım: İçerik oluşturmadan önce makale yapınızı planlayın
Üretmeyi planladığınız her makale için, herhangi bir yapay zeka aracına dokunmadan önce 3 şeyi tanımlayın:
- Yanıtladığı tam soru — iç terminolojinizi değil, biletlerdeki müşteri ifadelerini kullanın
- Okuduktan sonraki sonuç — müşteri kendi başına ne yapabilmeli?
- Kimin için — yeni kullanıcılar, yöneticiler, belirli bir plan kademesi?
Bu 60 dakikalık planlama oturumu karşılığını verir. Net bir sonuç olmadan yazılan makaleler yeniden yazılır. Gerçek müşteri diline dayalı makaleler aramada bulunur.
Orta ölçekli bir SaaS ürünü için tam işlevsel bir bilgi tabanı, genellikle 6-8 kategoride 50-100 makaleyi kapsar. Yapay zekanın bunları ne kadar hızlı üretebileceğini görene kadar bu çok gibi görünür.
3. Adım: Makale oluşturmak için yapay zeka bilgi tabanı oluşturucu kullanın
Zaman tasarrufunun gerçek olduğu yer burasıdır. 2 ana yaklaşım vardır.
Seçenek 1: Yapay zeka yazma araçları
Taslak bir yanıtı veya bilet dizisini ChatGPT gibi bir araca yapıştırır ve bir yardım makalesi üretmesini istersiniz. Bu, basit SSS'ler için işe yarar. Görsel bir iş akışı, kullanıcı arayüzü navigasyonu veya çok adımlı bir süreç içeren her şey için kalite tutarsızdır. Doğruluk ve yapı için düzenleme yaparak zaman harcarsınız.
Seçenek 2: Çözümü kaydedin, yapay zeka makaleyi oluştursun
Yazılım anlatımları ve süreç ağırlıklı konular için bu yaklaşım önemli ölçüde daha hızlı ve daha doğrudur. Clevera gibi bir araçla, çözümü uygularken ekranınızı kaydedersiniz ve yapay zeka, bu kayıttan cilalı, adım adım bir yardım makalesini otomatik olarak oluşturur. Yazmaya gerek yoktur.
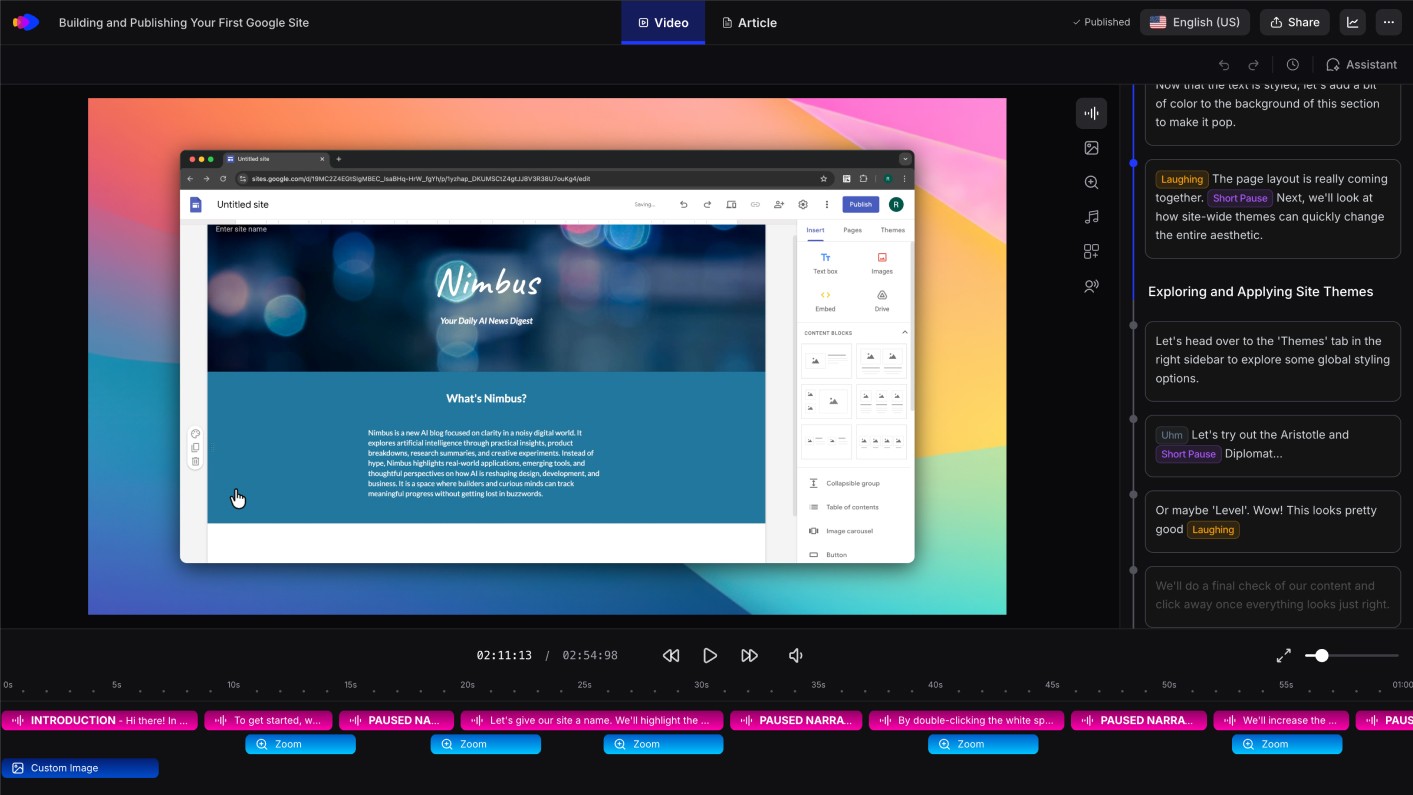
Çıktı doğrudur çünkü hafızadan yazılan kaba bir açıklamadan değil, ekranda gerçekten yaptıklarınızdan türetilmiştir. Bir süreç 14 adımdan oluşuyorsa, makale de 14 adımdan oluşur, doğru sırayla ve hiçbir adım eksik olmadan.
Yazılım iş akışları etrafında bir bilgi tabanı oluşturan destek ekipleri için, yapay zeka ile ölçeklenebilir bir bilgi tabanı oluşturmanın en pratik yolu budur.
Clevera bir makale oluşturduğunda, onu doğrudan bilgi tabanı platformunuzda yayınlayabilirsiniz. Pro ve üzeri sürümlerde Notion, Confluence, HelpScout, GitHub ve daha fazlasına bağlanır, böylece araçlar arasında manuel kopyala-yapıştır yapmanıza gerek kalmaz.
4. Adım: Yayınlamadan önce her makaleyi inceleyin
Yapay zeka tarafından oluşturulan içeriğin insan incelemesinden geçmesi gerekir. Bu, sıfırdan yeniden yazmak anlamına gelmez. Çoğu makale için 10 dakikalık bir kontrol yeterlidir.
Şunlara bakın:
- Doğruluk: makale ürününüzün 6 ay önce değil, bugün nasıl çalıştığını yansıtıyor mu?
- Tamlık: müşterilerin karşılaştığı uç durumları veya hata durumlarını kapsıyor mu?
- Ton: markanız gibi mi yoksa genel bir dokümantasyon gibi mi duyuluyor?
- Bağlantı: bilgi tabanınızda zaten var olan ilgili makalelere işaret ediyor mu?
Tutarlı bir kalite çıtası belirleyin ve bunu her makaleye uygulayın. Tutarsız dokümantasyon, müşterilerin bir bilgi tabanına güvenmeyi bırakıp bunun yerine bilet göndermeye geri dönmelerinin ana nedenlerinden biridir.
5. Adım: İlk günden itibaren bir bakım süreci oluşturun
Bayatlayan bir bilgi tabanı, hiç bilgi tabanı olmamasından daha fazla zarar verir. Müşteriler güncel olmayan talimatlar bulur, bunları uygular, neden çalışmadığını soran bir bilet açar ve o noktadan itibaren bilgi tabanına daha az güvenirler.
Bakımı sürecinize en başından itibaren dahil edin:
- Makale incelemelerini sürüm döngünüze bağlayın. Bir özellik değiştiğinde, ilgili makalelerin iki hafta sonra değil, aynı anda güncellenmesi gerekir.
- Hangi makalelerin hala bilet oluşturduğunu takip edin. Müşteriler bir makaleyi okuyup yine de desteğe ulaşıyorsa, o makalenin yeniden yazılması gerekir. Çoğu yardım masası bunu basit bir etiketle ortaya çıkarabilir.
- Her makaleye bir inceleme tarihi belirleyin. Düzenli olarak güncellenen bir üründe hiçbir şey 90 günden fazla dokunulmadan kalmamalıdır.
Clevera ürün güncellemelerine yardımcı olur: kullanıcı arayüzünüz değiştiğinde, güncellenmiş akışı yeniden kaydedebilir ve makaleyi yeniden oluşturabilirsiniz; artık güncel olmayan kısımları bulmak için metin paragrafları arasında arama yapmanıza gerek kalmaz. Daha küçük düzeltmeler için LiveSync, düzenlenen bir videonun gömülü olduğu her yerde yeni sürümü oynatması anlamına gelir.
6. Adım: Sadece makale sayısını değil, önlemeyi ölçün
80 makale yayınlamak, bilgi tabanınızın çalıştığı anlamına gelmez. Önemli olan metrik bilet önlemedir: müşteriler desteğe ulaşmadan önce yanıtları bulabiliyor mu?
Takip edin:
- Aynı konularda bilgi tabanı görüntülemeleri vs. bilet hacmi — insanlar makaleyi okuyor ancak yine de bilet açıyorsa, makale sorunu çözmüyor demektir
- Sonuçsuz arama sorguları — bilet oluşturan içeriğinizdeki boşluklar
- Makale derecelendirmeleri ve geri bildirimler — çoğu bilgi tabanı platformu beğenme/beğenmeme özelliğini destekler; düşük puanlı makaleler yeniden yazılmayı bekleyen adaylardır
Bir bilgi tabanı asla bitmez. Destek bileti hacminde en büyük azalmayı gören ekipler, buna bir proje değil, bir ürün olarak yaklaşırlar. İçerik, özellikler gibi yayınlanır, ölçülür ve üzerinde yinelemeler yapılır.
Başlarken
En yaygın 10 destek biletinizle başlayın. Ekibinizden birinin her biri için çözümü uygulamasını kaydedin. Bir yapay zeka bilgi tabanı oluşturucunun bu kayıtları makalelere dönüştürmesine izin verin. İnceleyin ve yayınlayın.
Bu, bir haftada değil, bir günde 10 makale demektir. Sonraki hafta bir sonraki 10 ile tekrar yapın. Bir ay içinde, tahminlere değil gerçek çözümlere dayalı, müşterilerin gerçekten sorduğu soruların büyük çoğunluğunu kapsayan bir bilgi tabanına sahip olacaksınız.
Kuyruk beklediğinizden daha hızlı sessizleşir.