AI dokümantasyon oluşturucu: neleri otomatize etmeli, neleri etmemeli
Otomasyon güçlü bir araçtır, ancak her şey yapay zeka tarafından oluşturulmamalıdır. Ürün dokümantasyonunuzun hangi bölümlerinin otomatize edilmesi gerektiğini ve 2026 yılında insan dokunuşunun nerede hala vazgeçilmez olduğunu keşfedin.
 Roozbeh Firoozmand6 dk okuma
Geçen ay, bir ürün ekibinin harika bir arayüz güncellemesi yayınladığını... ve sessizce yardım merkezlerini ateşe verdiğini izledim.
Kelimenin tam anlamıyla değil. Ama çok yakındı.
Dokümanlar hala eski buton etiketlerini gösteriyordu. Eğitim videosu, artık var olmayan bir menüye yönlendiriyordu. Destek ekibi, karanlıkta LEGO'ya basmak gibi hissettiren o "takıldım" biletlerini almaya başladı.
İşte o an şu ayartıcı düşünce geliyor: "Her şeyi yeniden oluşturmak için bir AI dokümantasyon oluşturucu kullanalım."
Elbette. Bir bifteği mikrodalgada da pişirebilirsiniz. Hızlı olur. Ama aynı zamanda üzücü de olur.
İşte kullandığımız kural: yargıya dayalı kısımları değil, gerçekler gibi davranan dokümantasyon kısımlarını otomatize edin. Otomasyonunuz tahmin yürütmeye başladığı an, "bayat dokümanları" "kendinden emin kurgularla" değiştirmiş olursunuz.
(Ve evet, ekran kaydından dokümantasyona geçişi ve bir adım adım kılavuz oluşturucunun sizi daha sonra utandırmadan nasıl çalışması gerektiğini ele alacağız.)
Bir AI dokümantasyon oluşturucu ne yapmalı (ve neden çoğu başarısız olur)
Bir AI dokümantasyon oluşturucu, güvenilir kaynakları (ürün arayüzleri, şemalar, değişiklik günlükleri ve kayıtlar gibi) güncel dokümantasyon taslaklarına dönüştüren, ardından bunları kontroller ve incelemelerle güncel tutan bir yazılımdır; böylece ekipler yanlış talimatlar yayınlamadan daha hızlı teslimat yapabilir.
Çoğu ekip, doğrulamayı otomatize etmek yerine "yazmayı" otomatize etmeye çalıştığı için başarısız olur.
En yüksek yatırım getirisi (ROI) sağlayan otomasyon "daha fazla sayfa oluşturmak" değildir.\n"Sapmayı müşterilerden önce yakalamaktır."
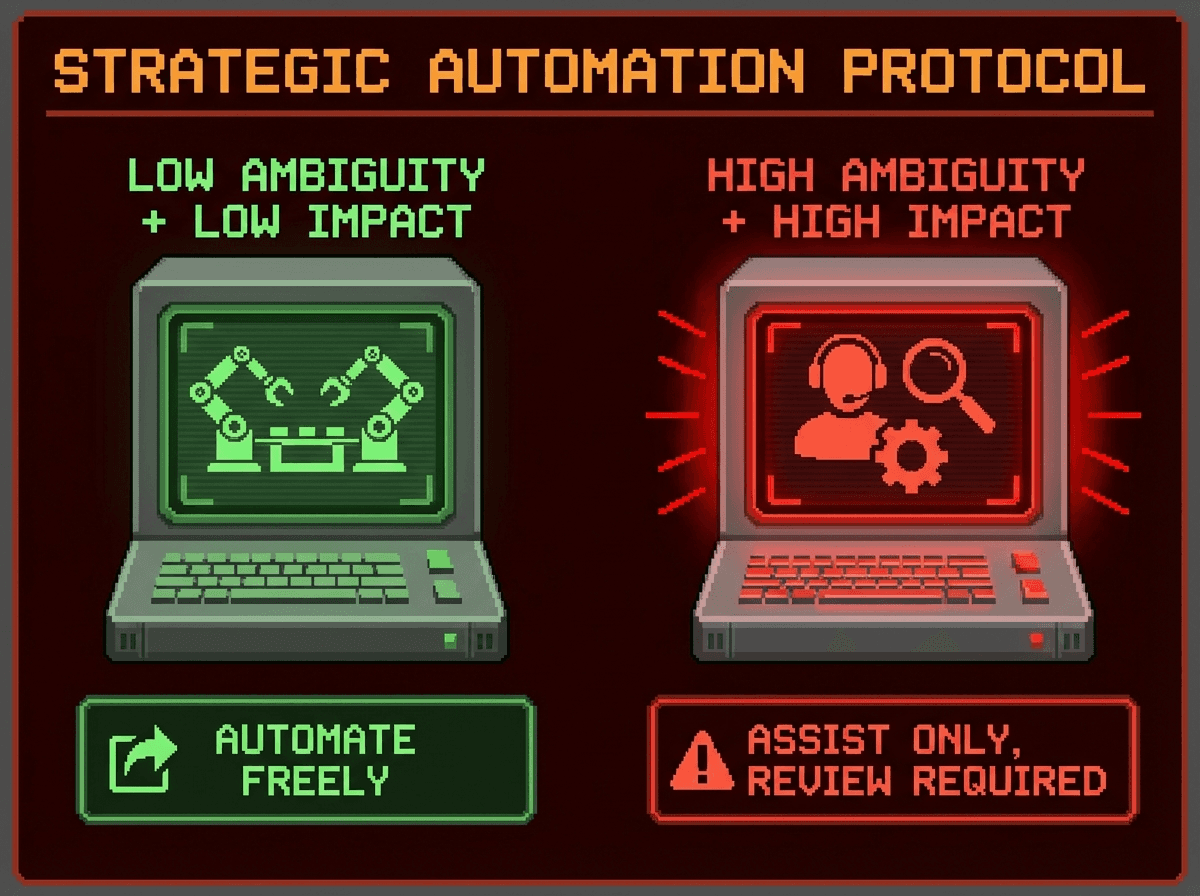
Bu karar çerçevesini kullanın: belirsizlik vs. etki alanı
Neyi otomatize edeceğinize karar verirken şu iki soruyu sorun:
1) Belirsizlik: Bu doküman yorumlama ve kurumsal bağlam gerektiriyor mu?\n2) Etki alanı: Bu yanlış olursa kim zarar görür?
- Düşük belirsizlik + düşük etki alanı = agresif bir şekilde otomatize edebilirsiniz.
- Yüksek belirsizlik + yüksek etki alanı = sadece destekleyici taslak olarak, sıkı inceleme kapılarıyla otomatize edin.
Kariyer kurtaran üçüncü bir soru daha isterseniz: Yapay zekanın referans gösterebileceği yetkili bir kaynağım var mı? (Eğer yoksa, otomatik yayın yapmamalıdır.)
Bu zihniyet, dokümanların yazılım gibi sürümlendiği, incelendiği ve kontrol edildiği "kod olarak doküman" iş akışlarıyla iyi uyum sağlar.
Bir AI dokümantasyon oluşturucu ile neler otomatize edilmeli (yüksek sinyal, düşük belirsizlik)
Yapılandırılmış kaynaklardan referans dokümanları oluşturun
Eğer "gerçeğiniz" bir şemada yaşıyorsa, şemanın öncülük etmesine izin verin.
- OpenAPI, AsyncAPI, GraphQL şemaları
- yazılı imzalar, protobuf'lar
- yapılandırma envanterleri
Bu güvenlidir çünkü çıktıları kaynağa göre doğrulayabilir ve sürüm yayınlandığında yeniden oluşturabilirsiniz. OpenAPI rehberliği, güvenilir teknik özellikler için yapılandırılmış, tasarım odaklı düşünmeyi güçlü bir şekilde destekler.
"Nihai gerçeği" değil, değişiklik özetlerini taslaklayın
Otomatize edin:
- PR başlıklarından, etiketlerinden ve commit'lerden sürüm notu taslakları
- doküman sahipleri için "neler değişti" farkları
Ardından bir insan incelemesi aşaması bırakın. Yapay zeka değişiklikleri öne çıkarmalı, önemli olup olmadıklarına karar vermemelidir.
Bir doküman envanteri tutun ve güncellik kontrolleri çalıştırın
Otomatize edin:
- hangi sayfaların var olduğu
- sahiplerinin kim olduğu
- X sürümüne göre en son ne zaman doğrulandığı
- hangi sayfaların bir sürümden sonra muhtemelen saptığı
Bu noktada hizmet katalogları parlar çünkü sahipliği sistemlere bağlar ve keşfedilebilirliği düzenli tutarlar.
Tutarlılığı ve hijyeni sağlayın
Düşük risk, yüksek kazanç:
- terminoloji tutarlılığı
- stil rehberi kontrolleri
- bozuk bağlantılar
- kod parçacığı biçimlendirmesi
Google'ın teknik yazım kaynakları, "sıkıcı ve okunabilir" bir metne ihtiyaç duyduğunuzda netlik ve tutarlılık için sağlam bir temel oluşturur.
Serbest oluşturma yerine getirme (retrieval) ile yanıtları iyileştirin
Dahili "nasıl yaparım?" soruları için getirme (retrieval), tahmin yürütmekten daha iyidir.
Anthropic'in Bağlamsal Getirme (Contextual Retrieval) üzerindeki çalışmaları, getirme hatalarını azaltmada büyük kazanımlar gösteriyor ve bu da RAG güvenilirliğini doğrudan artırıyor.
Neler otomatize edilmemeli (veya sadece sıkı bir uzman incelemesiyle yapılmalı)
Eğer AI doküman oluşturucunuz bunlardan herhangi birine dokunuyorsa, kapılar ekleyin veya hiç otomatize etmeyin:
Mimari mantık ve ödünleşimler
Yapay zeka bir ADR'yi özetleyebilir, ancak koddan "neden X'i seçtiğimizi" güvenilir bir şekilde çıkaramaz. Akıllı görünen ama tamamen yanlış olan bir dokümanla bu şekilde karşılaşırsınız.
Üretim ortamını bozabilecek operasyonel kılavuzlar
Üretim durumunu değiştiren her şey (veritabanı geri yüklemeleri, olay adımları, anahtar rotasyonu) bir sahip, prova ve inceleme gerektirir.
Güvenlik ve gizlilik rehberliği
Otomatik oluşturucunun güvensiz kalıpları normalleştirmesine veya dahili topolojiyi sızdırmasına izin vermeyin.
Performans iddiaları ve kıyaslamalar
Ölçülmediyse, bu pazarlamadır. Bunu insanlara bırakın.
Derlenmesi veya çalışması gereken kod örnekleri
CI'da test edemiyorsanız, otomatik yayınlamayın.
Kendi görüşüm olan kural: Doğrulayamıyorsanız, "taslak" olarak etiketleyin veya gizli tutun. "Yardımcı" otomatik dokümanların, sağladıkları faydadan daha fazla iş yükü yarattığını gördüm.
Ekran kaydından dokümantasyona: sizi dürüst tutan kısayol
İşte az kullanılan bir numara: belirsizlik yüksek olduğunda, yapay zekadan "netlik icat etmesini" istemeyi bırakın ve bunun yerine ona kanıt verin.
İyi bir ekran kaydından dokümantasyona iş akışı modeli tersine çevirir:
- Gerçeğin kaynağı yapay zekanın düz yazısı değildir.
- Gerçeğin kaynağı kaydedilen iş akışıdır: tıklamalar, alanlar, arayüz durumu ve sıra.
İşte tam da bu yüzden, ham ve sessiz ekran kayıtlarını anlatımlı bir ürün videosuna ve yapılandırılmış, ekran görüntüsü açısından zengin bir makaleye tek bir akışta dönüştürmek için Clevera ürününü geliştirdik. Kayıt temel oluşturur ve doküman, yaratıcı bir yazma egzersizi değil, sadık bir tekrar haline gelir.
Bağlamsal CTA: Ekibiniz her sürümde aynı "nasıl yapılır" rehberini yeniden yazıyorsa, bir sonraki iş akışını bir Clevera kaydına dönüştürmeyi deneyin ve doğrudan yardım merkezinize veya Pro ve üzeri planlarda wikinize aktarın. Ekran görüntülerini kovalamak zorunda kalmadığınız ilk seferde farkı hissedeceksiniz.
Dahili olarak kullandığımız Google'da bulunamayan içgörü: Her "nasıl yapılır" dokümanına "bir sayfa" değil, "bir tekrar" olarak yaklaşın.\nSonucun nasıl üretildiğini tekrar edemiyorsanız, bir arayüz değişikliğiyle saçmalığa düşmeye çok yakınsınız demektir.
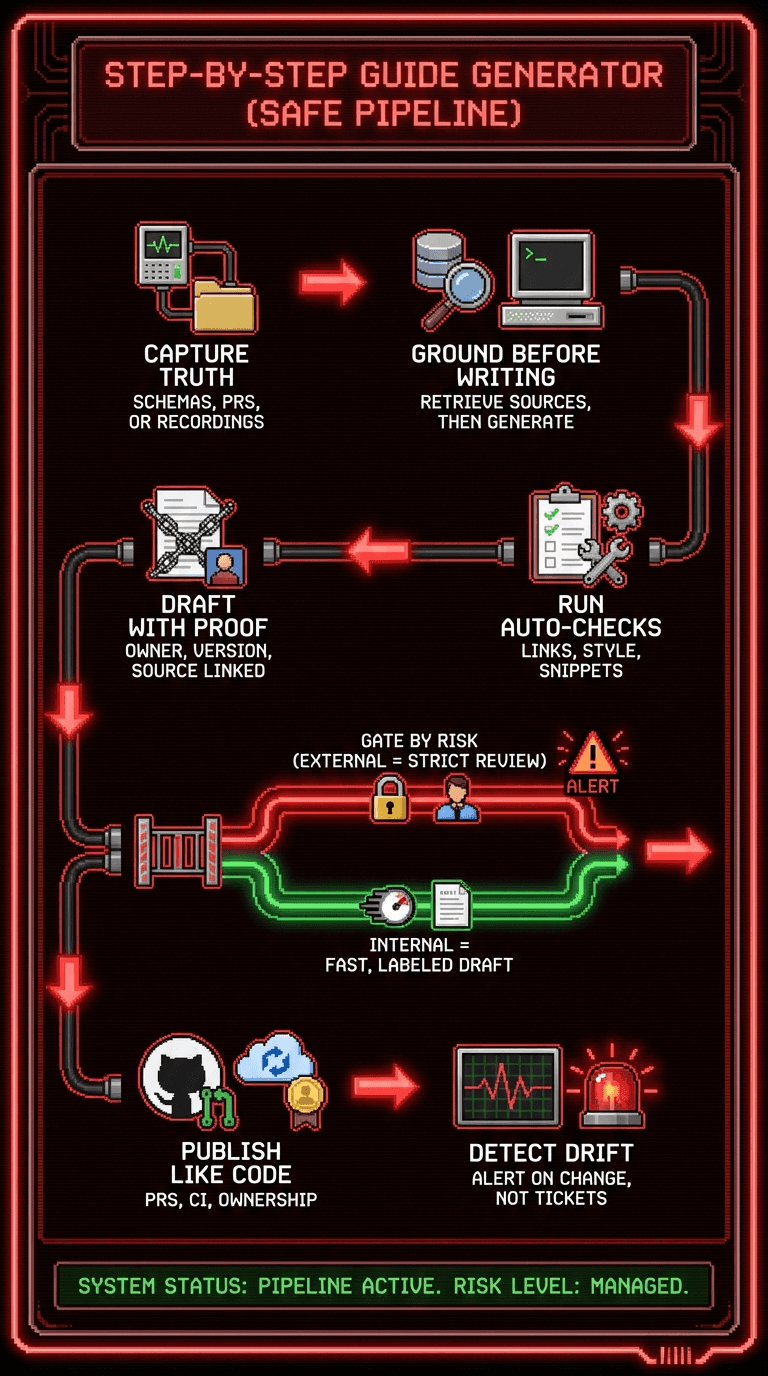
Sizi utandırmayacak bir adım adım kılavuz oluşturucu hattı
Bir adım adım kılavuz oluşturucu, ancak onu bir içerik slot makinesi gibi değil, bir mühendislik hattı gibi çalıştırdığınızda güvenilir hale gelir.
İşte önerdiğim iş akışı:
- Yetkili girdileri yakalayın
- şemalar, PR meta verileri veya kayıtlar (arayüz iş akışları için en iyisi)
- Önce temellendirin, sonra oluşturun
- alıntılarla getirme veya yapılandırılmış kaynaklardan deterministik çıkarma
- "Doğrulama meta verileri" ile bir taslak oluşturun
- sahip, son doğrulanan sürüm, bağlantılı kaynak PR, "taslak vs doğrulandı"
- Otomatik kontrolleri çalıştırın
- bağlantı kontrolleri, stil kontrolleri, kod parçacığı biçimlendirmesi
- Risk bazlı kapılar koyun
- harici dokümanlar: daha sıkı inceleme ve sürümleme
- dahili dokümanlar: daha hızlı, ancak taslakları net bir şekilde etiketleyin
- Kod gibi yayınlayın
- PR incelemesi, CI geçişleri, net sahiplik
- Sapmayı tespit edin
- sahibine "neler değişti" uyarıları
- destek biletlerinin izleme sisteminiz olmasını beklemeyin
Bu aynı zamanda platform mühendisliğinin temel hedefiyle de uyumludur: herkesin kurumsal bilgi labirentlerinde kaybolmasına izin vermek yerine, net "altın yollarla (golden paths)" bilişsel yükü azaltın.
İki hafta içinde yayınlayabileceğiniz ilk kazanımlar
Kaostan başlıyorsanız, "büyük bir yeniden yazım" yapmayın. Birleşerek büyüyen üç küçük otomasyon yapın:
- Referans doküman oluşturma
- şemadan dokümana, her sürümde yeniden oluştur
- Bayatlık tespiti
- sahipler + "son doğrulanan" meta verileri
- Değişiklik günlüğü taslakları
- otomatik taslak, insan inceleme aşaması
Bunlar, en hızlı "destek bileti azaltma" getirisine sahip en güvenli otomasyonlardır.
Dokümanlarınızın gerçek olduğunu kanıtlayan görseller (kurumsal duvar kağıdı değil)
El sıkışan stok fotoğrafları atlayın. Kanıt kullanın:
- Bir drift paneli ekran görüntüsü “bu sürümde doğrulanan” ve “bilinmeyen” sayfaları gösteriyor
- Alt metin: “Doğrulanmış ve güncelliğini yitirmiş yardım merkezi sayfalarını gösteren AI dokümantasyon oluşturucu paneli”
- Açıklamalı bir ekran görüntüsü dizisi (sayılar + oklar) bir iş akışı adımı için
- Alt metin: “Numaralandırılmış adımlar ve vurgulanmış arayüz öğeleriyle ekran kaydından dokümantasyon çıktısına”
- Bir sürüm PR'ından güncellenen belgenin öncesi/sonrası farkı
Eğitim içerikleri yayınlıyorsanız, videoyu makalenin üzerine yerleştirin; böylece kullanıcılar tercih ettikleri öğrenme stilini seçebilirler. Clevera tam olarak bu formatı dışa aktarır: üstte video, altta adım adım makale.
Bir sonraki adımınız
Bu hafta müşterilerinizin güvendiği bir belgeyi seçin.
Hızlı bir 2×2 matris çizin: belirsizlik ve etki alanı.
Ardından güvenli bir dilimi (referans, drift tespiti veya kayıt tabanlı nasıl yapılır belgeleri) otomatikleştirin ve riskli dilime bir inceleme kapısı koyun.
Eğer doğru yaparsanız, sadece daha hızlı yayınlamakla kalmayacaksınız. Daha rahat uyuyacaksınız.
Meydan okuma: Şu anda ürününüzde “yetkili görünüp yanlış olan” bir belge nedir ve hangi girdi onu tekrar oynatılabilir hale getirirdi: bir şema, bir PR farkı veya bir ekran kaydı?