KI-Dokumentationsgenerator: Was man automatisieren sollte und was nicht
Letzten Monat habe ich beobachtet, wie ein Produktteam ein schönes UI-Update veröffentlichte … und dabei stillschweigend sein Hilfe-Center in Brand steckte.
Nicht buchstäblich. Aber fast.
Die Dokumentation zeigte noch die alten Button-Beschriftungen. Das Onboarding-Video verwies Nutzer auf ein Menü, das nicht mehr existierte. Der Support erhielt plötzlich diese „Ich komme nicht weiter“-Tickets, die sich anfühlen, als würde man im Dunkeln auf einen LEGO-Stein treten.
Genau dann kommt die Versuchung auf: „Lass uns einen KI-Dokumentationsgenerator verwenden, um alles neu zu generieren.“
Sicher. Und man kann auch ein Steak in der Mikrowelle zubereiten. Es geht schnell. Aber es wird auch traurig sein.
Hier ist die Regel, die wir anwenden: Automatisieren Sie die Teile der Dokumentation, die wie Fakten behandelt werden können, nicht die Teile, die auf Urteilsvermögen basieren. In dem Moment, in dem Ihre Automatisierung beginnt, Absichten zu erraten, haben Sie „veraltete Dokumente“ gegen „selbstbewusste Fiktion“ eingetauscht.
(Und ja, wir behandeln auch Bildschirmaufzeichnung für die Dokumentation und wie ein Schritt-für-Schritt-Anleitungsgenerator tatsächlich funktionieren sollte, ohne Sie später in Verlegenheit zu bringen.)
Was ein KI-Dokumentationsgenerator tun sollte (und warum die meisten scheitern)
Ein KI-Dokumentationsgenerator ist eine Software, die zuverlässige Quellen (wie Produkt-UIs, Schemata, Changelogs und Aufzeichnungen) in aktualisierte Dokumentationsentwürfe umwandelt und diese dann durch Prüfungen und Reviews aktuell hält, damit Teams schneller liefern können, ohne falsche Anleitungen zu veröffentlichen.
Die meisten Teams scheitern, weil sie das „Schreiben“ automatisieren, anstatt die Verifizierung zu automatisieren.
Die Automatisierung mit dem höchsten ROI besteht nicht darin, „mehr Seiten zu generieren“. Sondern darin, „Abweichungen zu erkennen, bevor es die Kunden tun“.
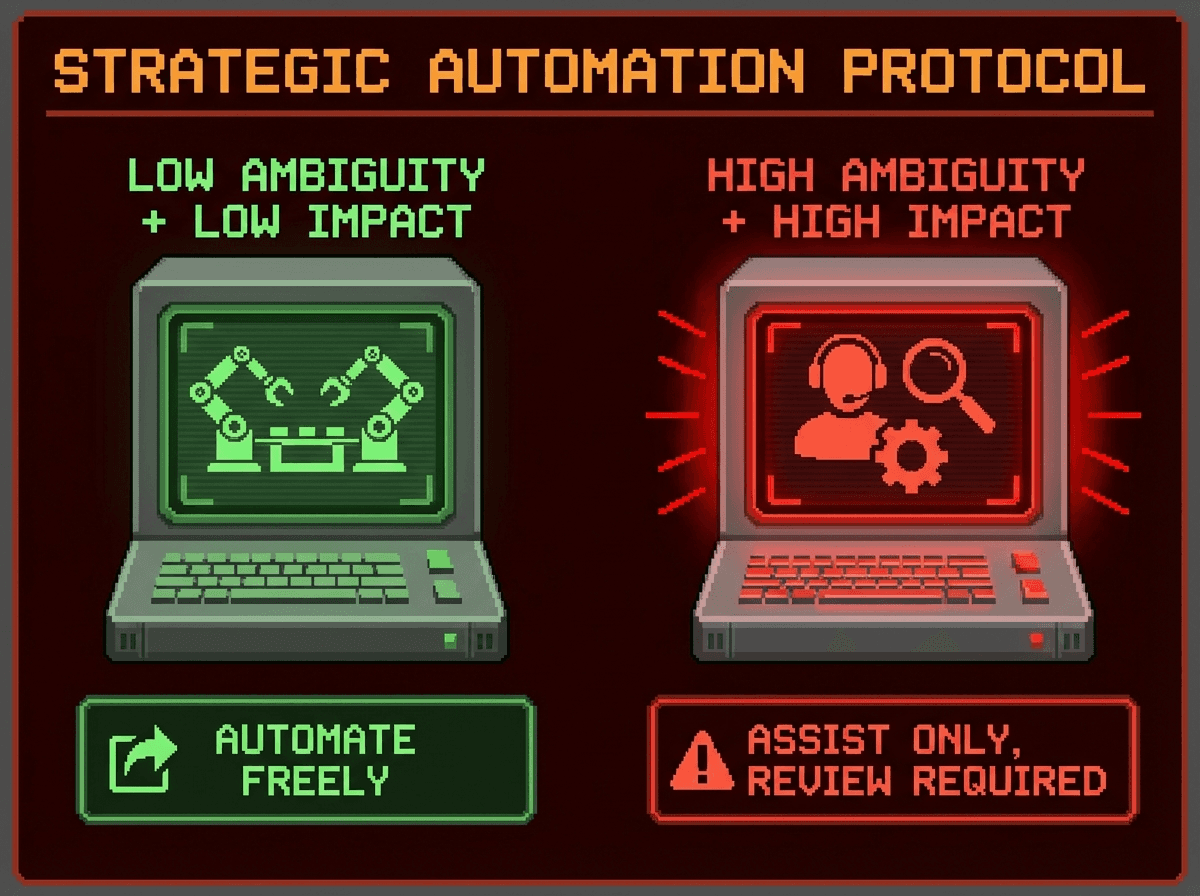
Nutzen Sie dieses Entscheidungs-Framework: Mehrdeutigkeit vs. Wirkungsradius
Wenn Sie entscheiden, was automatisiert werden soll, stellen Sie zwei Fragen:
1) Mehrdeutigkeit: Erfordert dieses Dokument Interpretation und internes Kontextwissen?
2) Wirkungsradius: Wer ist betroffen, wenn dies falsch ist?
- Geringe Mehrdeutigkeit + geringer Wirkungsradius = Sie können aggressiv automatisieren.
- Hohe Mehrdeutigkeit + hoher Wirkungsradius = Automatisieren Sie nur als unterstützenden Entwurf, mit strengen Review-Gates.
Wenn Sie eine dritte Frage möchten, die Karrieren rettet: Habe ich eine maßgebliche Quelle, die die KI zitieren kann? (Wenn nicht, sollte sie nicht automatisch veröffentlichen.)
Diese Denkweise passt gut zu „Docs as Code“-Workflows, bei denen Dokumente wie Software versioniert, geprüft und kontrolliert werden.
Was man mit einem KI-Dokumentationsgenerator automatisieren sollte (hohes Signal, geringe Mehrdeutigkeit)
Referenzdokumente aus strukturierten Quellen generieren
Wenn Ihre „Wahrheit“ in einem Schema lebt, lassen Sie das Schema führen.
- OpenAPI, AsyncAPI, GraphQL-Schemata
- Typisierte Signaturen, Protobufs
- Konfigurationsinventare
Dies ist sicher, da Sie die Ausgaben gegen die Quelle validieren und bei einem Release neu generieren können. OpenAPI-Richtlinien unterstützen nachdrücklich ein strukturiertes, Design-First-Denken für zuverlässige Spezifikationen.
Zusammenfassungen von Änderungen entwerfen, nicht die „endgültige Wahrheit“
Automatisieren Sie:
- Entwürfe für Release-Notes aus PR-Titeln, Labels und Commits
- „Was hat sich geändert“-Diffs für Dokumentationsverantwortliche
Behalten Sie dann einen menschlichen Korrekturdurchgang bei. Die KI sollte Änderungen hervorheben, nicht entscheiden, ob sie wichtig sind.
Ein Dokumentationsinventar führen und Aktualitätsprüfungen durchführen
Automatisieren Sie:
- Welche Seiten existieren
- Wer ist verantwortlich
- Wann wurden sie zuletzt gegen Version X geprüft
- Welche Seiten sind nach einem Release wahrscheinlich veraltet
Hier glänzen Service-Kataloge, da sie Verantwortlichkeiten mit Systemen verknüpfen und die Auffindbarkeit übersichtlich halten.
Konsistenz und Hygiene durchsetzen
Geringes Risiko, hoher Nutzen:
- Terminologie-Konsistenz
- Styleguide-Prüfungen
- Defekte Links
- Snippet-Formatierung
Googles Ressourcen für technisches Schreiben sind eine solide Basis für Klarheit und Konsistenz, wenn Sie „langweilig und lesbar“ benötigen.
Antworten durch Retrieval verbessern, nicht durch freie Generierung
Bei internen „Wie mache ich…?“-Fragen schlägt Retrieval das bloße Raten.
Anthroplics Arbeit an Contextual Retrieval zeigt große Fortschritte bei der Reduzierung von Retrieval-Fehlern, was die RAG-Zuverlässigkeit direkt verbessert.
Was man nicht automatisieren sollte (oder nur hinter strengen SME-Reviews)
Wenn Ihr KI-Dokumentationsgenerator einen dieser Bereiche berührt, fügen Sie Kontrollschritte hinzu oder automatisieren Sie es gar nicht:
Architektur-Begründungen und Kompromisse
KI kann ein ADR zusammenfassen, aber sie kann nicht zuverlässig aus dem Code ableiten, „warum wir X gewählt haben“. So erhalten Sie ein Dokument, das klug klingt, aber völlig falsch ist.
Runbooks, die die Produktion unterbrechen können
Alles, was den Produktionsstatus ändert (DB-Wiederherstellungen, Vorfallschritte, Schlüsselrotation), benötigt einen Verantwortlichen, eine Probe und eine Überprüfung.
Sicherheits- und Datenschutzrichtlinien
Lassen Sie keinen automatischen Generator unsichere Muster normalisieren oder interne Topologien preisgeben.
Leistungsversprechen und Benchmarks
Wenn es nicht gemessen wurde, ist es Marketing. Lassen Sie hier Menschen ran.
Code-Beispiele, die kompilieren oder laufen müssen
Wenn Sie es nicht in CI testen können, veröffentlichen Sie es nicht automatisch.
Meine subjektive Regel: Wenn Sie es nicht validieren können, kennzeichnen Sie es als „Entwurf“ oder halten Sie es privat. Ich habe gesehen, wie „hilfreiche“ automatische Dokumente mehr Arbeit verursachten, als sie einsparten.
Bildschirmaufzeichnung für die Dokumentation: die Abkürzung, die Sie ehrlich hält
Hier ist der zu wenig genutzte Trick: Wenn die Mehrdeutigkeit hoch ist, hören Sie auf, die KI zu bitten, „Klarheit zu erfinden“, und geben Sie ihr stattdessen Beweise.
Ein guter Workflow für Bildschirmaufzeichnung für die Dokumentation dreht das Modell um:
- Die Quelle der Wahrheit ist nicht die Prosa der KI.
- Die Quelle der Wahrheit ist der aufgezeichnete Workflow: die Klicks, Felder, UI-Zustände und die Sequenz.
Genau deshalb haben wir Clevera entwickelt, um rohe, stumme Bildschirmaufnahmen in einem Durchgang in ein kommentiertes Produktvideo und einen strukturierten, screenshot-reichen Artikel zu verwandeln. Die Aufnahme liefert die Grundlage, und das Dokument wird zu einer getreuen Wiedergabe, nicht zu einer kreativen Schreibübung.
Kontextueller CTA: Wenn Ihr Team bei jedem Release dieselbe „Wie-macht-man“-Anleitung neu schreibt, versuchen Sie, den nächsten Workflow in eine Clevera-Aufnahme zu verwandeln und diese direkt in Ihr Hilfe-Center oder Wiki zu exportieren. Sie werden den Unterschied beim ersten Mal spüren, wenn Sie keine Screenshots mehr jagen müssen.
Eine nicht googelbare Erkenntnis, die wir intern nutzen: Behandeln Sie jedes „Wie-macht-man“-Dokument als „Wiedergabe“, nicht als „Seite“.
Wenn Sie nicht wiedergeben können, wie das Ergebnis erzielt wurde, sind Sie nur eine UI-Änderung vom Unsinn entfernt.
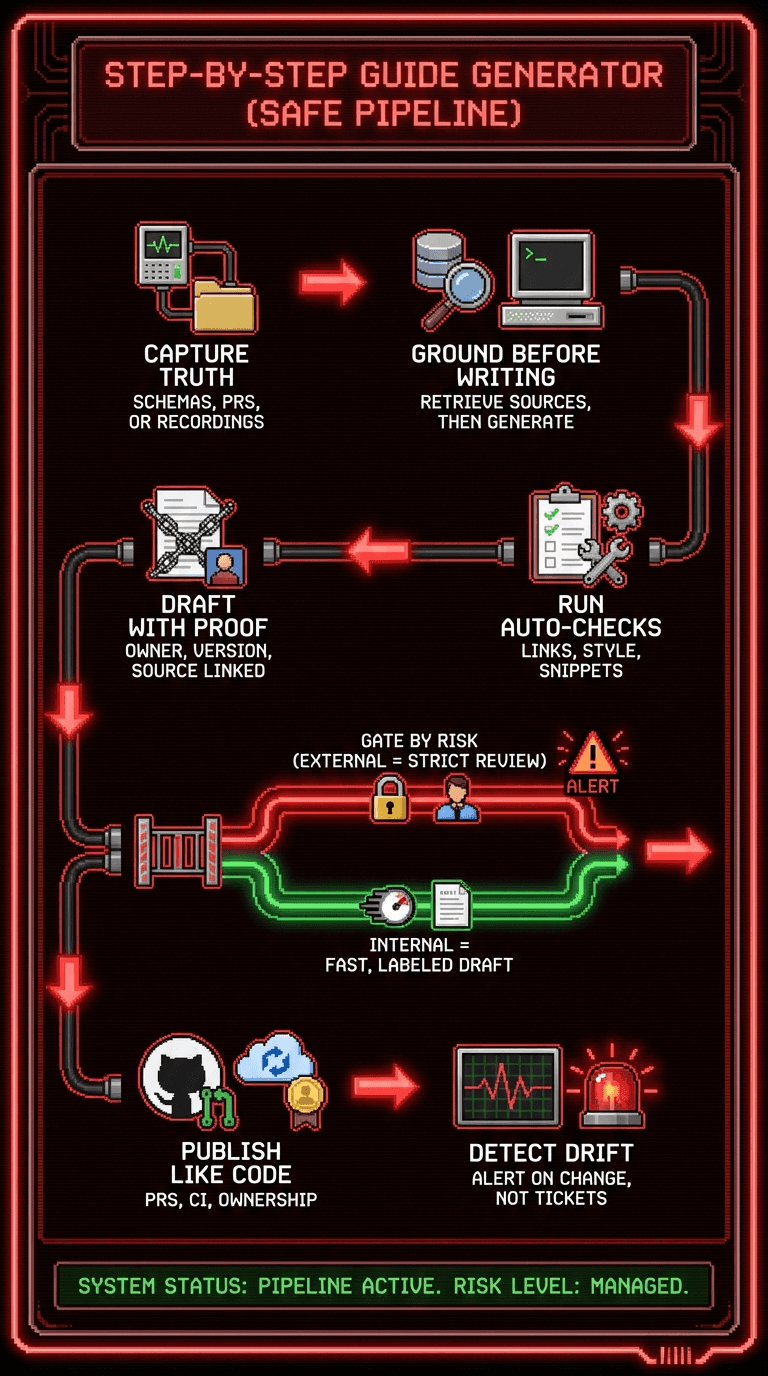
Eine Pipeline für einen Schritt-für-Schritt-Anleitungsgenerator, die Sie nicht in Verlegenheit bringt
Ein Schritt-für-Schritt-Anleitungsgenerator wird erst dann vertrauenswürdig, wenn Sie ihn wie eine Engineering-Pipeline betreiben, nicht wie einen Content-Spielautomaten.
Hier ist der Workflow, den ich empfehle:
- Maßgebliche Eingaben erfassen
- Schemata, PR-Metadaten oder Aufzeichnungen (am besten für UI-Workflows)
- Zuerst fundieren, dann generieren
- Retrieval mit Zitaten oder deterministische Extraktion aus strukturierten Quellen
- Entwurf mit „Verifizierungs-Metadaten“ generieren
- Verantwortlicher, zuletzt verifizierte Version, verknüpfte Quell-PR, „Entwurf vs. verifiziert“
- Automatisierte Prüfungen ausführen
- Link-Prüfungen, Stil-Prüfungen, Snippet-Formatierung
- Nach Risiko filtern
- Externe Dokumente: strengere Überprüfung und Versionierung
- Interne Dokumente: schneller, aber Entwürfe klar kennzeichnen
- Veröffentlichen wie Code
- PR-Review, CI-Durchläufe, klare Verantwortlichkeiten
- Abweichungen erkennen
- „Was hat sich geändert“-Benachrichtigungen an den Verantwortlichen
- Warten Sie nicht darauf, dass Support-Tickets Ihr Überwachungssystem werden
Dies stimmt auch mit dem Kernziel des Platform Engineerings überein: Reduzierung der kognitiven Belastung durch klare „Golden Paths“, anstatt jeden durch das Stammeswissen irren zu lassen.
Erste Erfolge, die Sie in zwei Wochen liefern können
Wenn Sie im Chaos starten, machen Sie kein „großes Rewrite“. Führen Sie drei kleine Automatisierungen durch, die sich summieren:
- Generierung von Referenzdokumenten
- Schema zu Dokumenten, pro Release neu generieren
- Erkennung von Veraltung
- Verantwortliche + „zuletzt verifiziert gegen“-Metadaten
- Changelog-Entwürfe
- Automatische Entwürfe, menschlicher Korrekturdurchgang
Dies sind die sichersten Automatisierungen mit dem schnellsten Nutzen für die „Vermeidung von Support-Tickets“.
Visualisierungen, die beweisen, dass Ihre Dokumente echt sind (keine Unternehmens-Tapete)
Überspringen Sie Händeschüttel-Stockfotos. Nutzen Sie Beweise:
- Ein Screenshot des Drift-Dashboards, der Seiten mit „in dieser Version verifiziert“ gegenüber „unbekannt“ anzeigt
- Alt-Text: „KI-Dokumentationsgenerator-Dashboard mit verifizierten gegenüber veralteten Hilfe-Center-Seiten“
- Eine annotierte Screenshot-Sequenz (Nummern + Pfeile) für einen Workflow-Schritt
- Alt-Text: „Bildschirmaufnahme zu Dokumentationsausgabe mit nummerierten Schritten und hervorgehobenen UI-Elementen“
- Ein Vorher/Nachher-Diff eines Dokuments, das aus einem Release-PR aktualisiert wurde
Wenn Sie Tutorials veröffentlichen, betten Sie das Video über dem Artikel ein, damit Nutzer ihren bevorzugten Lernstil wählen können. Clevera exportiert genau dieses Format: Video oben, Schritt-für-Schritt-Artikel darunter.
Ihr nächster Schritt
Wählen Sie diese Woche ein Dokument aus, auf das sich Ihre Kunden verlassen.
Zeichnen Sie eine schnelle 2×2-Matrix: Mehrdeutigkeit vs. Tragweite.
Automatisieren Sie dann einen sicheren Teilbereich (Referenz, Drift-Erkennung oder auf Aufnahmen basierende How-to-Dokumente) und setzen Sie eine Prüfinstanz für den riskanten Teilbereich ein.
Wenn Sie es richtig machen, werden Sie nicht nur schneller veröffentlichen. Sie werden auch ruhiger schlafen.
Herausforderung: Welches Dokument in Ihrem Produkt sieht aktuell „autoritär aus, ist aber falsch“, und welcher Input würde es reproduzierbar machen: ein Schema, ein PR-Diff oder eine Bildschirmaufnahme?