AI documentation generator: สิ่งที่ควรทำอัตโนมัติและสิ่งที่ไม่ควร
ระบบอัตโนมัติมีพลังมหาศาล แต่ไม่ใช่ทุกอย่างที่ควรให้ AI สร้างขึ้น ค้นหาว่าส่วนใดของเอกสารผลิตภัณฑ์ของคุณที่ควรเป็นอัตโนมัติ และส่วนใดที่ยังคงต้องใช้ความเป็นมนุษย์ในปี 2026
 Roozbeh Firoozmandใช้เวลาอ่าน 9 นาที
เมื่อเดือนที่แล้ว ผมเห็นทีมผลิตภัณฑ์ปล่อยอัปเดต UI ที่สวยงาม... แล้วก็เผาศูนย์ช่วยเหลือของตัวเองทิ้งอย่างเงียบๆ
ไม่ได้เผาจริงๆ หรอก แต่ก็ใกล้เคียง
เอกสารยังคงแสดงป้ายกำกับปุ่มแบบเก่า วิดีโอแนะนำการใช้งานยังคงชี้ให้ผู้ใช้ไปที่เมนูที่ไม่มีอยู่แล้ว ฝ่ายสนับสนุนเริ่มได้รับตั๋วแจ้งปัญหา “ฉันติดขัด” ที่ให้ความรู้สึกเหมือนเหยียบตัวต่อเลโก้ในความมืด
นั่นคือตอนที่ความอยากรู้อยากลองเข้ามา: “มาใช้ AI documentation generator เพื่อสร้างทุกอย่างขึ้นใหม่กันเถอะ”
แน่นอนครับ คุณจะเอาสเต็กไปเข้าไมโครเวฟก็ได้ มันจะเร็ว แต่มันก็จะน่าเศร้าด้วยเช่นกัน
นี่คือกฎที่เราใช้: ทำส่วนที่เป็น ข้อเท็จจริง ให้เป็นอัตโนมัติ ไม่ใช่ส่วนที่ต้องใช้ วิจารณญาณ ทันทีที่ระบบอัตโนมัติของคุณเริ่มเดาเจตนา คุณก็แค่เปลี่ยนจาก “เอกสารที่ล้าสมัย” เป็น “นิยายที่ดูมั่นใจ”
(และใช่ เราจะพูดถึง การบันทึกหน้าจอเป็นเอกสาร และวิธีที่ ตัวสร้างคู่มือทีละขั้นตอน ควรทำงานจริงๆ โดยไม่ทำให้คุณต้องอับอายในภายหลัง)
สิ่งที่ AI documentation generator ควรทำ (และทำไมส่วนใหญ่ถึงล้มเหลว)
AI documentation generator คือซอฟต์แวร์ที่เปลี่ยนแหล่งข้อมูลที่เชื่อถือได้ (เช่น UI ผลิตภัณฑ์, สคีมา, บันทึกการเปลี่ยนแปลง และการบันทึกหน้าจอ) ให้เป็นร่างเอกสารที่อัปเดตแล้ว จากนั้นคอยรักษาให้เป็นปัจจุบันผ่านการตรวจสอบและการทบทวน เพื่อให้ทีมส่งมอบงานได้เร็วขึ้นโดยไม่ต้องเผยแพร่คำแนะนำที่ผิดพลาด
ทีมส่วนใหญ่ล้มเหลวเพราะพวกเขาทำ “การเขียน” ให้เป็นอัตโนมัติ แทนที่จะทำ การตรวจสอบ ให้เป็นอัตโนมัติ
ระบบอัตโนมัติที่ให้ผลตอบแทนสูงสุดไม่ใช่ “การสร้างหน้าเพิ่ม”
แต่คือ “การตรวจจับความคลาดเคลื่อนก่อนที่ลูกค้าจะพบ”
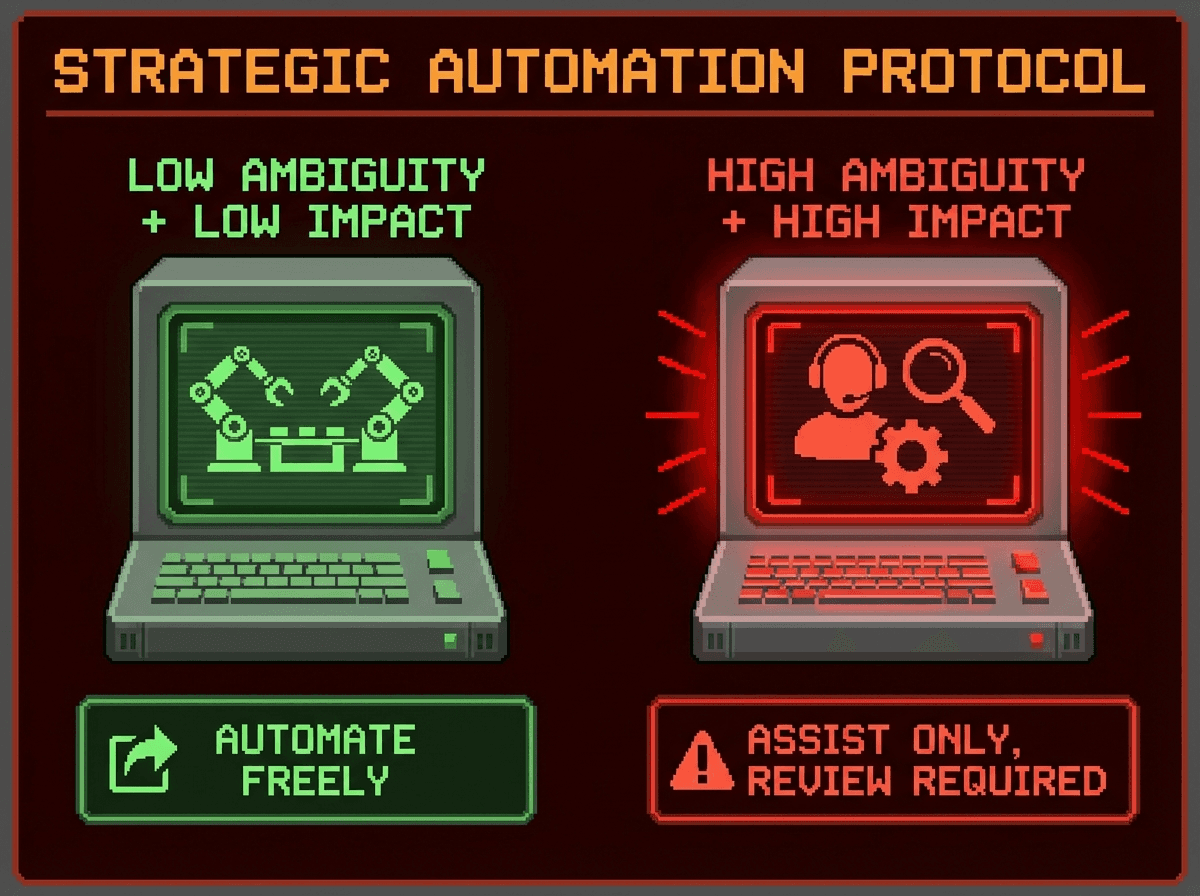
ใช้กรอบการตัดสินใจนี้: ความคลุมเครือ vs ขอบเขตผลกระทบ
เมื่อคุณตัดสินใจว่าจะทำอะไรให้เป็นอัตโนมัติ ให้ถามสองคำถามนี้:
1) ความคลุมเครือ: เอกสารนี้ต้องอาศัยการตีความและบริบทภายในทีมหรือไม่?
2) ขอบเขตผลกระทบ: ใครจะได้รับผลกระทบหากข้อมูลนี้ผิด?
- ความคลุมเครือต่ำ + ขอบเขตผลกระทบต่ำ = คุณสามารถทำอัตโนมัติได้อย่างเต็มที่
- ความคลุมเครือสูง + ขอบเขตผลกระทบสูง = ทำอัตโนมัติได้เพียงแค่ช่วยร่างเท่านั้น โดยต้องมีขั้นตอนการตรวจสอบที่เข้มงวด
หากคุณต้องการคำถามที่สามที่จะช่วยรักษาอาชีพของคุณไว้: ฉันมีแหล่งข้อมูลที่เชื่อถือได้ที่ AI สามารถอ้างอิงได้หรือไม่? (ถ้าไม่มี ก็ไม่ควรเผยแพร่อัตโนมัติ)
แนวคิดนี้เข้ากันได้ดีกับเวิร์กโฟลว์ “docs as code” ที่เอกสารจะถูกกำหนดเวอร์ชัน ทบทวน และตรวจสอบเหมือนกับซอฟต์แวร์
สิ่งที่ควรทำอัตโนมัติด้วย AI documentation generator (สัญญาณชัดเจน, ความคลุมเครือต่ำ)
สร้างเอกสารอ้างอิงจากแหล่งข้อมูลที่มีโครงสร้าง
หาก “ความจริง” ของคุณอยู่ในสคีมา ก็ให้สคีมาเป็นตัวนำ
- สคีมา OpenAPI, AsyncAPI, GraphQL
- ลายเซ็นแบบพิมพ์ (typed signatures), protobufs
- รายการการตั้งค่า (config inventories)
วิธีนี้ปลอดภัยเพราะคุณสามารถตรวจสอบผลลัพธ์เทียบกับแหล่งข้อมูลและสร้างใหม่เมื่อมีการปล่อยอัปเดต คำแนะนำของ OpenAPI สนับสนุนแนวคิดแบบเน้นโครงสร้างและออกแบบก่อนเป็นอย่างดี เพื่อให้ได้ข้อมูลจำเพาะที่เชื่อถือได้
ร่างสรุปการเปลี่ยนแปลง ไม่ใช่ “ความจริงสุดท้าย”
ทำอัตโนมัติในส่วนของ:
- ร่างบันทึกประจำรุ่นจากชื่อ PR, ป้ายกำกับ และคอมมิต
- ผลต่าง “สิ่งที่เปลี่ยนไป” สำหรับเจ้าของเอกสาร
จากนั้นให้มนุษย์เข้ามาแก้ไข AI ควรเน้นย้ำการเปลี่ยนแปลง ไม่ใช่ตัดสินว่าสิ่งเหล่านั้นสำคัญหรือไม่
จัดทำรายการเอกสารและตรวจสอบความสดใหม่
ทำอัตโนมัติในส่วนของ:
- หน้าใดที่มีอยู่
- ใครเป็นเจ้าของ
- ตรวจสอบครั้งล่าสุดเมื่อใดเทียบกับเวอร์ชัน X
- หน้าใดที่มีแนวโน้มคลาดเคลื่อนหลังการปล่อยอัปเดต
นี่คือจุดที่ service catalogs โดดเด่น เพราะเชื่อมโยงความเป็นเจ้าของเข้ากับระบบและทำให้การค้นหาเป็นเรื่องง่าย
บังคับใช้ความสม่ำเสมอและสุขอนามัยของเอกสาร
ความเสี่ยงต่ำ ผลตอบแทนสูง:
- ความสม่ำเสมอของคำศัพท์
- การตรวจสอบคู่มือสไตล์
- ลิงก์ที่เสีย
- การจัดรูปแบบโค้ดตัวอย่าง
แหล่งข้อมูลการเขียนเชิงเทคนิคของ Google เป็นพื้นฐานที่ดีสำหรับความชัดเจนและความสม่ำเสมอ เมื่อคุณต้องการความ “เรียบง่ายและอ่านง่าย”
ปรับปรุงคำตอบด้วยการดึงข้อมูล ไม่ใช่การสร้างแบบอิสระ
สำหรับคำถามภายในประเภท “ฉันจะ...ได้อย่างไร?” การดึงข้อมูลนั้นดีกว่าการเดาสุ่ม
งานของ Anthropic เกี่ยวกับ Contextual Retrieval แสดงให้เห็นถึงผลลัพธ์ที่ดีในการลดความล้มเหลวของการดึงข้อมูล ซึ่งช่วยปรับปรุงความน่าเชื่อถือของ RAG โดยตรง
สิ่งที่ไม่ควรทำอัตโนมัติ (หรือทำได้ต่อเมื่อผ่านการตรวจสอบจากผู้เชี่ยวชาญเท่านั้น)
หาก AI doc generator ของคุณแตะต้องสิ่งเหล่านี้ ให้เพิ่มขั้นตอนการตรวจสอบหรืออย่าทำอัตโนมัติเลย:
เหตุผลเบื้องหลังสถาปัตยกรรมและการแลกเปลี่ยน
AI สามารถสรุป ADR ได้ แต่ไม่สามารถอนุมาน “ทำไมเราถึงเลือก X” จากโค้ดได้อย่างน่าเชื่อถือ นั่นคือวิธีที่คุณจะได้เอกสารที่ฟังดูฉลาดแต่ผิดพลาดโดยสิ้นเชิง
คู่มือปฏิบัติงานที่อาจทำให้ระบบพัง
อะไรก็ตามที่เปลี่ยนสถานะของระบบจริง (การกู้คืนฐานข้อมูล, ขั้นตอนเมื่อเกิดเหตุการณ์, การหมุนเวียนคีย์) จำเป็นต้องมีเจ้าของ การซ้อม และการตรวจสอบ
คำแนะนำด้านความปลอดภัยและความเป็นส่วนตัว
อย่าปล่อยให้ตัวสร้างอัตโนมัติทำให้รูปแบบที่ไม่ปลอดภัยกลายเป็นเรื่องปกติ หรือเปิดเผยโครงสร้างภายใน
การกล่าวอ้างด้านประสิทธิภาพและเกณฑ์มาตรฐาน
ถ้าไม่ได้วัดผล มันก็คือการตลาด ให้มนุษย์จัดการเรื่องนี้เถอะ
ตัวอย่างโค้ดที่ต้องคอมไพล์หรือรันได้
ถ้าคุณทดสอบใน CI ไม่ได้ ก็อย่าเผยแพร่อัตโนมัติ
กฎส่วนตัวของผมคือ: ถ้าคุณตรวจสอบไม่ได้ ให้ติดป้ายว่า “ร่าง” หรือเก็บไว้เป็นส่วนตัว ผมเคยเห็นเอกสารอัตโนมัติที่ “หวังดี” สร้างงานให้มากกว่าที่ช่วยประหยัด
การบันทึกหน้าจอเป็นเอกสาร: ทางลัดที่ช่วยให้คุณซื่อสัตย์
นี่คือเคล็ดลับที่ถูกใช้น้อย: เมื่อความคลุมเครือสูง อย่าขอให้ AI “สร้างความชัดเจน” แต่ให้ หลักฐาน แทน
เวิร์กโฟลว์ การบันทึกหน้าจอเป็นเอกสาร ที่ดีจะพลิกโมเดลนี้:
- แหล่งความจริงไม่ใช่คำบรรยายของ AI
- แหล่งความจริงคือเวิร์กโฟลว์ที่บันทึกไว้: การคลิก, ช่องกรอกข้อมูล, สถานะ UI และลำดับขั้นตอน
นี่คือเหตุผลที่เราสร้าง Clevera ขึ้นมา เพื่อเปลี่ยนการบันทึกหน้าจอแบบดิบๆ ที่ไม่มีเสียง ให้เป็นวิดีโอผลิตภัณฑ์ที่มีคำบรรยาย และ บทความที่มีโครงสร้างพร้อมภาพหน้าจอในขั้นตอนเดียว การบันทึกให้ข้อมูลที่ชัดเจน และเอกสารจะกลายเป็นการเล่นซ้ำที่ซื่อตรง ไม่ใช่การฝึกเขียนเชิงสร้างสรรค์
Contextual CTA: หากทีมของคุณต้องเขียนวิธีใช้งานเดิมซ้ำๆ ทุกครั้งที่มีการอัปเดต ลองเปลี่ยนเวิร์กโฟลว์ถัดไปเป็นการบันทึกด้วย Clevera แล้วส่งออกไปยังศูนย์ช่วยเหลือของคุณโดยตรง หรือถ้าใช้รุ่น Pro ขึ้นไป ก็ส่งไปยังวิกิของคุณ คุณจะรู้สึกถึงความแตกต่างในครั้งแรกที่คุณไม่ต้องคอยไล่จับภาพหน้าจอ
ข้อมูลเชิงลึกที่หาไม่ได้จาก Google ซึ่งเราใช้ภายในคือ: ปฏิบัติต่อเอกสารวิธีใช้งานทุกฉบับเหมือน “การเล่นซ้ำ” ไม่ใช่ “หน้ากระดาษ”
ถ้าคุณไม่สามารถเล่นซ้ำวิธีที่ได้ผลลัพธ์นั้นมาได้ คุณก็อยู่ห่างจากการเปลี่ยนแปลง UI เพียงก้าวเดียวที่จะทำให้ทุกอย่างกลายเป็นเรื่องไร้สาระ
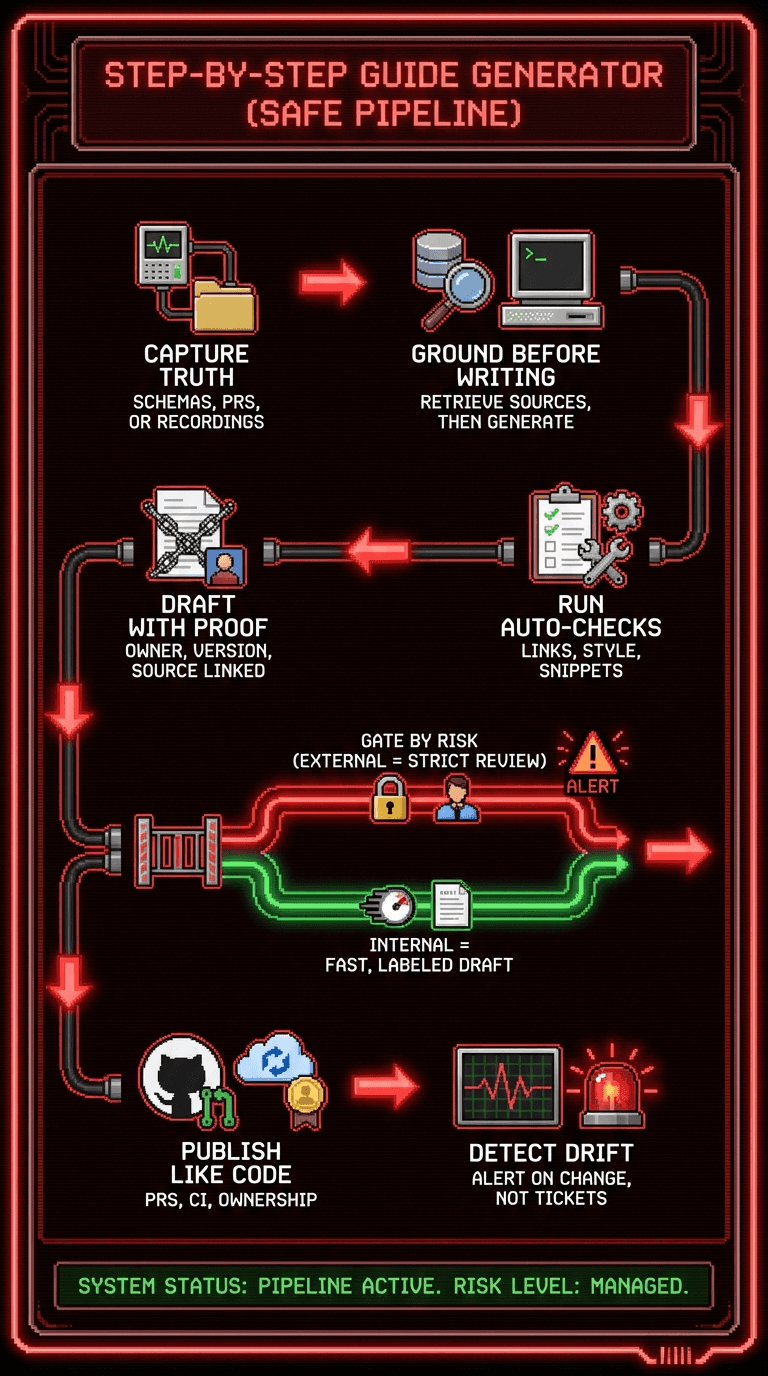
ไปป์ไลน์ตัวสร้างคู่มือทีละขั้นตอนที่จะไม่ทำให้คุณต้องอับอาย
ตัวสร้างคู่มือทีละขั้นตอน จะเชื่อถือได้ก็ต่อเมื่อคุณรันมันเหมือนไปป์ไลน์ทางวิศวกรรม ไม่ใช่เครื่องสล็อตเนื้อหา
นี่คือเวิร์กโฟลว์ที่ผมแนะนำ:
- รวบรวมข้อมูลที่เชื่อถือได้
- สคีมา, ข้อมูลเมตาของ PR, หรือการบันทึก (ดีที่สุดสำหรับเวิร์กโฟลว์ UI)
- วางรากฐานก่อน สร้างทีหลัง
- การดึงข้อมูลพร้อมการอ้างอิง หรือการสกัดข้อมูลแบบกำหนดได้จากแหล่งข้อมูลที่มีโครงสร้าง
- สร้างร่างพร้อม “ข้อมูลเมตาการตรวจสอบ”
- เจ้าของ, เวอร์ชันที่ตรวจสอบล่าสุด, ลิงก์ PR ต้นทาง, “ร่าง vs ตรวจสอบแล้ว”
- รันการตรวจสอบอัตโนมัติ
- ตรวจสอบลิงก์, ตรวจสอบสไตล์, การจัดรูปแบบโค้ดตัวอย่าง
- คัดกรองตามความเสี่ยง
- เอกสารภายนอก: การทบทวนและกำหนดเวอร์ชันที่เข้มงวดขึ้น
- เอกสารภายใน: เร็วขึ้น แต่ติดป้ายกำกับร่างให้ชัดเจน
- เผยแพร่เหมือนโค้ด
- การทบทวน PR, ผ่าน CI, ความเป็นเจ้าของที่ชัดเจน
- ตรวจจับความคลาดเคลื่อน
- การแจ้งเตือน “สิ่งที่เปลี่ยนไป” ถึงเจ้าของ
- อย่ารอให้ตั๋วสนับสนุนกลายเป็นระบบตรวจสอบของคุณ
สิ่งนี้ยังสอดคล้องกับเป้าหมายหลักของวิศวกรรมแพลตฟอร์ม: ลดภาระทางความคิดด้วย “เส้นทางทองคำ (golden paths)” ที่ชัดเจน แทนที่จะปล่อยให้ทุกคนต้องงมเข็มหาความรู้ภายในทีม
ชัยชนะครั้งแรกที่คุณสามารถส่งมอบได้ในสองสัปดาห์
หากคุณกำลังเริ่มต้นจากความโกลาหล อย่าทำ “การเขียนใหม่ครั้งใหญ่” ให้ทำระบบอัตโนมัติเล็กๆ สามอย่างที่ส่งเสริมกัน:
- การสร้างเอกสารอ้างอิง
- สคีมาเป็นเอกสาร, สร้างใหม่ทุกครั้งที่ปล่อยอัปเดต
- การตรวจจับความล้าสมัย
- เจ้าของ + ข้อมูลเมตา “ตรวจสอบล่าสุดเทียบกับ”
- ร่างบันทึกการเปลี่ยนแปลง
- ร่างอัตโนมัติ, มนุษย์ตรวจสอบแก้ไข
นี่คือระบบอัตโนมัติที่ปลอดภัยที่สุดและให้ผลตอบแทนในการ “ลดตั๋วสนับสนุน” ได้เร็วที่สุด
ภาพประกอบที่พิสูจน์ว่าเอกสารของคุณเป็นของจริง (ไม่ใช่ภาพวอลเปเปอร์องค์กร)
ข้ามภาพสต็อกจับมือไปเถอะ ใช้หลักฐานจริงดีกว่า:
- ภาพหน้าจอแดชบอร์ดแสดงความคลาดเคลื่อน ที่แสดงหน้าเว็บ “ตรวจสอบแล้วในรุ่นนี้” เทียบกับ “ไม่ทราบสถานะ”
- Alt text: “แดชบอร์ดเครื่องมือสร้างเอกสาร AI แสดงหน้าศูนย์ช่วยเหลือที่ตรวจสอบแล้วเทียบกับที่ล้าสมัย”
- ลำดับภาพหน้าจอที่มีคำอธิบายประกอบ (ตัวเลข + ลูกศร) สำหรับขั้นตอนการทำงาน
- Alt text: “การบันทึกหน้าจอเป็นผลลัพธ์เอกสารพร้อมขั้นตอนที่มีหมายเลขและองค์ประกอบ UI ที่เน้นไว้”
- ภาพเปรียบเทียบก่อน/หลัง ของเอกสารที่อัปเดตจาก PR ของรุ่นที่ปล่อยออกมา
หากคุณเผยแพร่บทช่วยสอน ให้ฝังวิดีโอไว้เหนือบทความเพื่อให้ผู้ใช้เลือกรูปแบบการเรียนรู้ที่ต้องการได้ Clevera ส่งออกในรูปแบบนี้โดยเฉพาะ: วิดีโออยู่ด้านบน และบทความทีละขั้นตอนอยู่ด้านล่าง
ก้าวต่อไปของคุณ
เลือกเอกสาร หนึ่ง ฉบับที่ลูกค้าของคุณต้องใช้งานในสัปดาห์นี้
วาดตาราง 2×2 อย่างรวดเร็ว: ความคลุมเครือเทียบกับขอบเขตผลกระทบ
จากนั้นทำระบบอัตโนมัติในส่วนที่ปลอดภัย (เอกสารอ้างอิง, การตรวจจับความคลาดเคลื่อน หรือคู่มือการใช้งานจากการบันทึกหน้าจอ) และตั้งจุดตรวจสอบสำหรับส่วนที่มีความเสี่ยง
หากคุณทำถูกต้อง คุณจะไม่เพียงแค่เผยแพร่ได้เร็วขึ้นเท่านั้น แต่คุณจะนอนหลับได้สนิทขึ้นด้วย
ความท้าทาย: เอกสารฉบับไหนในผลิตภัณฑ์ของคุณตอนนี้ที่ “ดูน่าเชื่อถือแต่กลับผิดพลาด” และข้อมูลนำเข้าแบบใดที่จะทำให้มันเล่นซ้ำได้: สคีมา, PR diff หรือการบันทึกหน้าจอ?