איך לבנות בסיס ידע בעזרת בינה מלאכותית
למדו איך לבנות בסיס ידע בעזרת בינה מלאכותית, החל מניתוח פניות תמיכה ועד לפרסום אוטומטי של מאמרי עזרה מלוטשים. מדריך מעשי לצוותי תמיכה.
 Roozbeh Firoozmand5 דקות קריאה
צוות התמיכה שלכם עונה על אותן 20 שאלות מדי שבוע. הלקוחות מחכים. הפניות נערמות. בסיס ידע פותר את זה, אבל בנייתו מאפס תמיד היוותה צוואר בקבוק. עם כלי ה-AI הנכונים, זה משתנה.
מדריך זה מכסה שלב אחר שלב איך לבנות בסיס ידע בעזרת בינה מלאכותית, החל מהבנה מה לכתוב ועד לשמירה על מאמרים עדכניים ללא צורך בכותב ייעודי בצוות.
למה פרויקטים של בסיס ידע נתקעים
לרוב הצוותים לא חסר ידע. חסר להם זמן לתעד אותו. מהנדס תמיכה בכיר יודע בדיוק איך לטפל ב-10 הבעיות המובילות שלכם, אבל יצירת מאמרי עזרה ברורים וניתנים לחיפוש עבור כל אחת מהן גוזלת שעות שאין לו.
יצירת בסיס ידע מבוסס AI משנה את אופן העבודה. במקום לכתוב מאמרים מאפס, אתם מכוונים את ה-AI להפיק אותם מהמומחיות שכבר קיימת בצוות שלכם. צוואר הבקבוק עובר מ"למצוא זמן לכתוב" ל"להקליט את עצמכם פותרים את הבעיה", שזה תהליך מהיר הרבה יותר.
שלב 1: נתחו את פניות התמיכה שלכם לפני שכותבים משהו
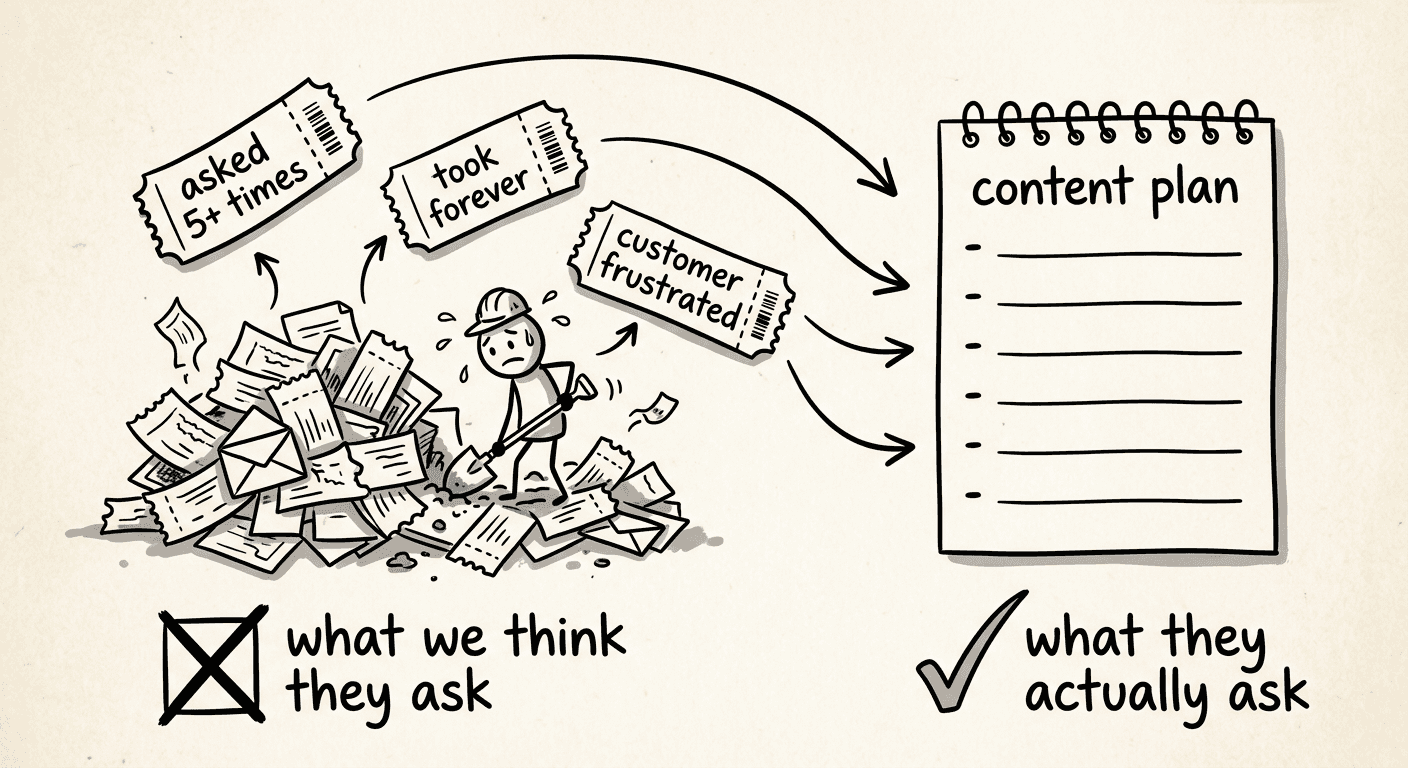
הטעות הגדולה ביותר שצוותים עושים היא לנחש אילו מאמרים לכתוב. לפני שיוצרים תוכן כלשהו, שלפו את פניות התמיכה הנפוצות ביותר שלכם מ-90 הימים האחרונים.
אתם מחפשים:
- שאלות שמופיעות יותר מ-5 פעמים
- בעיות שלוקח יותר מ-5 דקות לפתור בפנייה
- נושאים שבהם לקוחות מביעים תסכול לגבי מציאת מידע בעצמם
הרשימה הזו היא תוכנית התוכן שלכם. רוב מערכות התמיכה (Zendesk, Intercom, Freshdesk) מאפשרות לסנן ולייצא פניות לפי תגית או קטגוריה. הקדישו זמן לעשות זאת כראוי. בסיס ידע שעונה על השאלות הלא נכונות לא מונע פניות.
קבצו את הנושאים ל-6-10 קטגוריות שתואמות את האופן שבו הלקוחות שלכם חושבים, לא את האופן שבו הצוותים הפנימיים שלכם מאורגנים. אם לקוחות קוראים לזה "חיוב", הקטגוריה שלכם היא "חיוב", לא "תפעול הכנסות".
שלב 2: תכננו את מבנה המאמר לפני יצירת התוכן
עבור כל מאמר שאתם מתכננים להפיק, הגדירו 3 דברים לפני שנוגעים בכלי AI כלשהו:
- השאלה המדויקת שהוא עונה עליה — השתמשו בניסוח של הלקוח מהפניות, לא במינוחים הפנימיים שלכם
- התוצאה לאחר הקריאה — מה הלקוח אמור להיות מסוגל לעשות בעצמו?
- למי זה מיועד — משתמשים חדשים, מנהלים, תוכנית ספציפית?
סשן תכנון של 60 דקות משתלם. מאמרים שנכתבו ללא תוצאה ברורה דורשים שכתוב. מאמרים המבוססים על שפת לקוח אמיתית נמצאים בחיפוש.
בסיס ידע מתפקד במלואו עבור מוצר SaaS בינוני מכסה בדרך כלל 50-100 מאמרים ב-6-8 קטגוריות. זה נשמע הרבה עד שרואים כמה מהר AI יכול לייצר אותם.
שלב 3: השתמשו בבונה בסיס ידע מבוסס AI כדי לייצר מאמרים
כאן החיסכון בזמן הופך לממשי. ישנן 2 גישות עיקריות.
אפשרות 1: כלי כתיבה מבוססי AI
אתם מדביקים תשובה גולמית או שרשור פניות לתוך כלי כמו ChatGPT ומבקשים ממנו להפיק מאמר עזרה. זה עובד עבור שאלות נפוצות פשוטות. האיכות אינה עקבית עבור כל מה שכולל תהליך עבודה ויזואלי, ניווט בממשק או תהליך רב-שלבי. אתם תבזבזו זמן בעריכה עבור דיוק ומבנה.
אפשרות 2: הקליטו את הפתרון, תנו ל-AI לייצר את המאמר
עבור מדריכי תוכנה ונושאים עתירי תהליכים, גישה זו מהירה ומדויקת משמעותית. עם כלי כמו Clevera, אתם מקליטים את המסך בזמן שאתם מדגימים את הפתרון, וה-AI מייצר אוטומטית מאמר עזרה מלוטש ומפורט שלב אחר שלב מתוך ההקלטה. אין צורך בכתיבה.
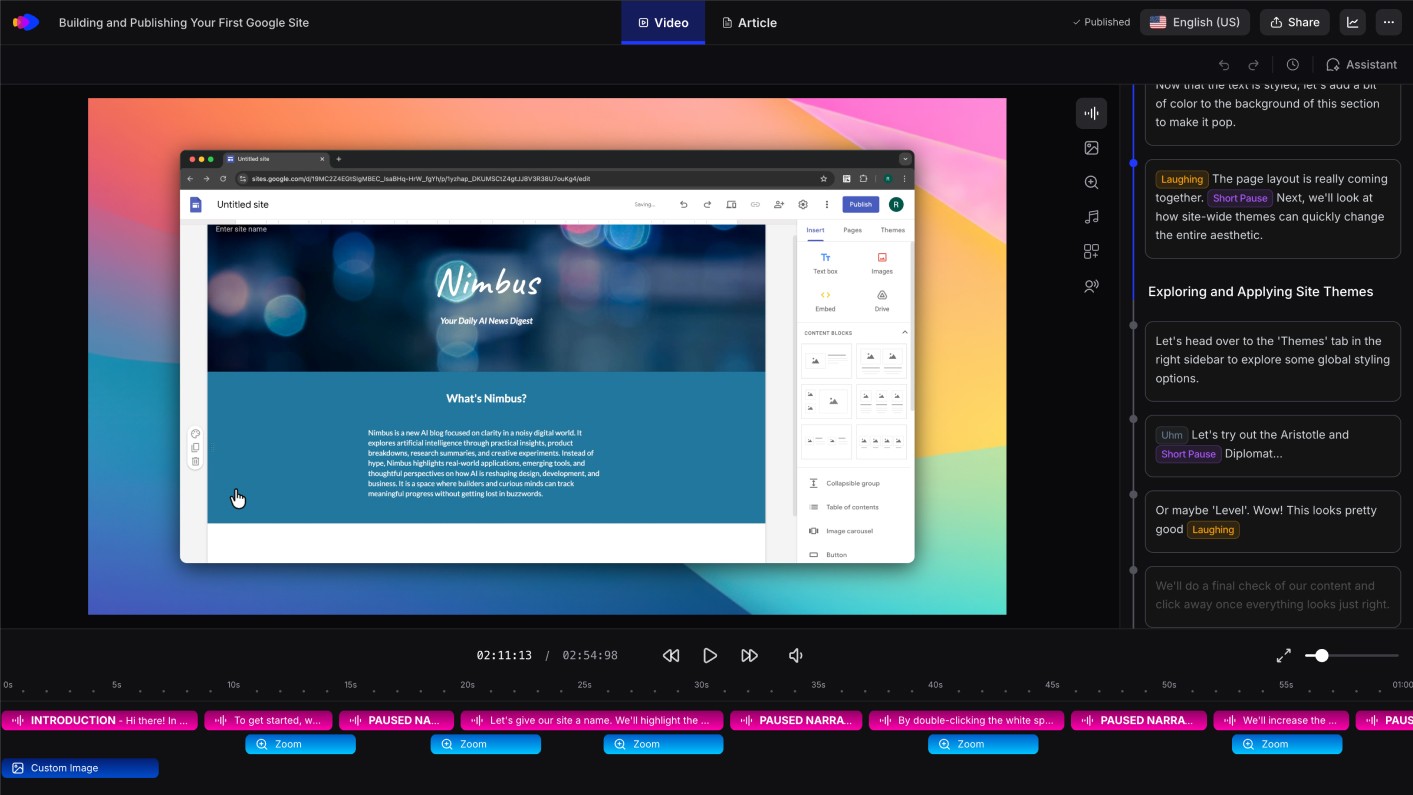
התוצר מדויק כי הוא נגזר ממה שעשיתם בפועל על המסך, לא מתיאור גס שהוקלד מהזיכרון. אם לתהליך יש 14 שלבים, למאמר יש 14 שלבים, בסדר הנכון, ללא שלבים חסרים.
עבור צוותי תמיכה הבונים בסיס ידע סביב תהליכי עבודה בתוכנה, זהו הנתיב המעשי ביותר ליצירת בסיס ידע בעזרת AI בהיקף רחב.
ברגע ש-Clevera מייצר מאמר, תוכלו לפרסם אותו ישירות לפלטפורמת בסיס הידע שלכם. בתוכניות Pro ומעלה, הוא מתחבר ל-Notion, Confluence, HelpScout, GitHub ועוד, כך שאין צורך בהעתק-הדבק ידני בין כלים.
שלב 4: עברו על כל מאמר לפני הפרסום
תוכן שנוצר על ידי AI זקוק לבדיקה אנושית. זה לא אומר שכתוב מאפס. עבור רוב המאמרים, בדיקה של 10 דקות מספיקה.
חפשו:
- דיוק: האם המאמר משקף איך המוצר שלכם עובד היום, לא לפני 6 חודשים?
- שלמות: האם הוא מכסה מקרי קצה או מצבי שגיאה שהלקוחות נתקלים בהם?
- טון: האם זה נשמע כמו המותג שלכם, או כמו תיעוד גנרי?
- קישורים: האם הוא מפנה למאמרים קשורים שכבר קיימים בבסיס הידע שלכם?
קבעו רף איכות עקבי והחילו אותו על כל מאמר. תיעוד לא עקבי הוא אחת הסיבות העיקריות לכך שלקוחות מפסיקים לסמוך על בסיס ידע וחוזרים להגיש פניות במקום.
שלב 5: בנו תהליך תחזוקה מהיום הראשון
בסיס ידע שהופך למיושן עושה יותר נזק מאשר חוסר בבסיס ידע. לקוחות מוצאים הוראות מיושנות, פועלים לפיהן, פותחים פנייה בשאלה למה זה לא עבד, וסומכים פחות על בסיס הידע מאותה נקודה והלאה.
בנו תחזוקה לתוך התהליך שלכם מההתחלה:
- קשרו סקירות מאמרים למחזור השחרור שלכם. כאשר תכונה משתנה, המאמרים הרלוונטיים צריכים להתעדכן באותו זמן, לא שבועיים לאחר מכן.
- עקבו אילו מאמרים עדיין מייצרים פניות. אם לקוחות קוראים מאמר ועדיין פונים לתמיכה, המאמר הזה זקוק לשכתוב. רוב מערכות התמיכה יכולות להציף זאת עם תגית פשוטה.
- קבעו תאריך סקירה לכל מאמר. שום דבר לא אמור להישאר ללא נגיעה במשך יותר מ-90 יום במוצר שמשתחרר באופן קבוע.
Clevera עוזר עם עדכוני מוצר: כשהממשק שלכם משתנה, אתם יכולים להקליט מחדש את התהליך המעודכן ולייצר מחדש את המאמר, במקום לחפש בין פסקאות טקסט כדי למצוא מה כבר לא מעודכן. עבור תיקונים קטנים יותר, LiveSync אומר שסרטון ערוך מציג את הגרסה החדשה בכל מקום שבו הוא מוטמע.
שלב 6: מדדו מניעת פניות, לא רק את מספר המאמרים
פרסום 80 מאמרים לא אומר שבסיס הידע שלכם עובד. המדד שקובע הוא מניעת פניות: האם לקוחות מוצאים תשובות לפני שהם פונים לתמיכה?
עקבו אחרי:
- צפיות בבסיס הידע לעומת נפח פניות באותם נושאים — אם אנשים קוראים את המאמר אבל עדיין פותחים פניות, המאמר לא פותר את הבעיה
- שאילתות חיפוש ללא תוצאות — פערים בתוכן שלכם שמייצרים פניות
- דירוגי מאמרים ומשוב — רוב פלטפורמות בסיס הידע תומכות בלייק/דיסלייק; מאמרים עם דירוג נמוך הם שכתובים שמחכים לקרות
בסיס ידע לעולם לא מסתיים. הצוותים שרואים את הירידה הגדולה ביותר בנפח פניות התמיכה מתייחסים אליו כמוצר, לא כפרויקט. תוכן משוחרר, נמדד ועובר איטרציות באותו אופן שבו תכונות עוברות.
איך מתחילים
התחילו עם 10 פניות התמיכה הנפוצות ביותר שלכם. הקליטו מישהו מהצוות שלכם מדגים את הפתרון עבור כל אחת מהן. תנו למחולל בסיס ידע מבוסס AI להפוך את ההקלטות האלה למאמרים. עברו עליהם ופרסמו.
אלו 10 מאמרים ביום, לא בשבוע. עשו זאת שוב בשבוע שלאחר מכן עם ה-10 הבאים. תוך חודש, יהיה לכם בסיס ידע שמכסה את הרוב המכריע של מה שלקוחות באמת שואלים, בנוי מפתרונות אמיתיים, לא מניחושים.
התור מתרוקן מהר יותר ממה שאתם מצפים.